「PoCでは問題なく動いたのに、本番環境へ入れたらエラーが増えた」「AIエージェントが何を根拠に処理したのか追えない」「担当者が毎回修正しているが、それを品質問題として把握できていない」。
AIエージェントを本番業務へ組み込むと、このような運用上の課題が出てきます。
結論から言うと、AIエージェントの運用監視では、「システムが落ちていないか」だけではなく、どの処理を行い、どこで失敗し、人がどこを修正し、業務上正しい結果になったかまで追える状態を作ることが重要です。
一般的なシステム監視で見るエラーや処理時間に加え、AIエージェントではモデル呼び出し、検索、ツール利用、承認、人による修正、再試行、最終的な業務結果まで複数段階があります。
本記事では、PoCの評価方法ではなく、すでに本番稼働しているAIエージェントを対象に、実行ログ、失敗・例外、人による修正率、誤判断、停止・エスカレーション、定期改善までを整理します。
この記事の要点
- AIエージェントの本番監視では、最終結果だけでなく実行経路を追える状態が必要です。
- ログには、実行日時・入力・利用ツール・結果・エラー・承認・再試行などを目的に応じて残します。
- 技術的に成功した処理でも、業務上は誤判断の場合があるため、エラー率だけでは品質を判断できません。
- 人の修正率・差し戻し理由は、プロンプト・データ・ルール・ワークフロー改善の重要な材料になります。
- 停止条件とエスカレーション先を事前に決め、異常発生後に担当者が判断する運用を避けます。
- AIエージェントの運用監視とは?
- PoCの評価と本番稼働後の監視は何が違う?
- なぜPoC後にも継続監視が必要なのか
- ログだけでなく「トレース」で実行経路を見る
- 実行ログには何を残す?
- 失敗・例外は一つの「エラー」にまとめない
- 人による修正率を見る
- 「誤判断」をどう検知する?
- 異常値だけでなく「変化」を監視する
- 停止・エスカレーション条件を決める
- アラートを重要度別に分ける
- 運用ダッシュボードで最低限確認したい指標
- 運用監視から定期改善へつなげる
- AIエージェントのワークフロー設計と運用監視を接続する
- IMMNの一次情報から考える本番運用のポイント
- AIエージェント運用監視の実務チェックリスト
- まとめ|本番運用では「動いているか」ではなく「正しく動き続けているか」を見る
- AIエージェントの運用監視に関するよくある質問
AIエージェントの運用監視とは?
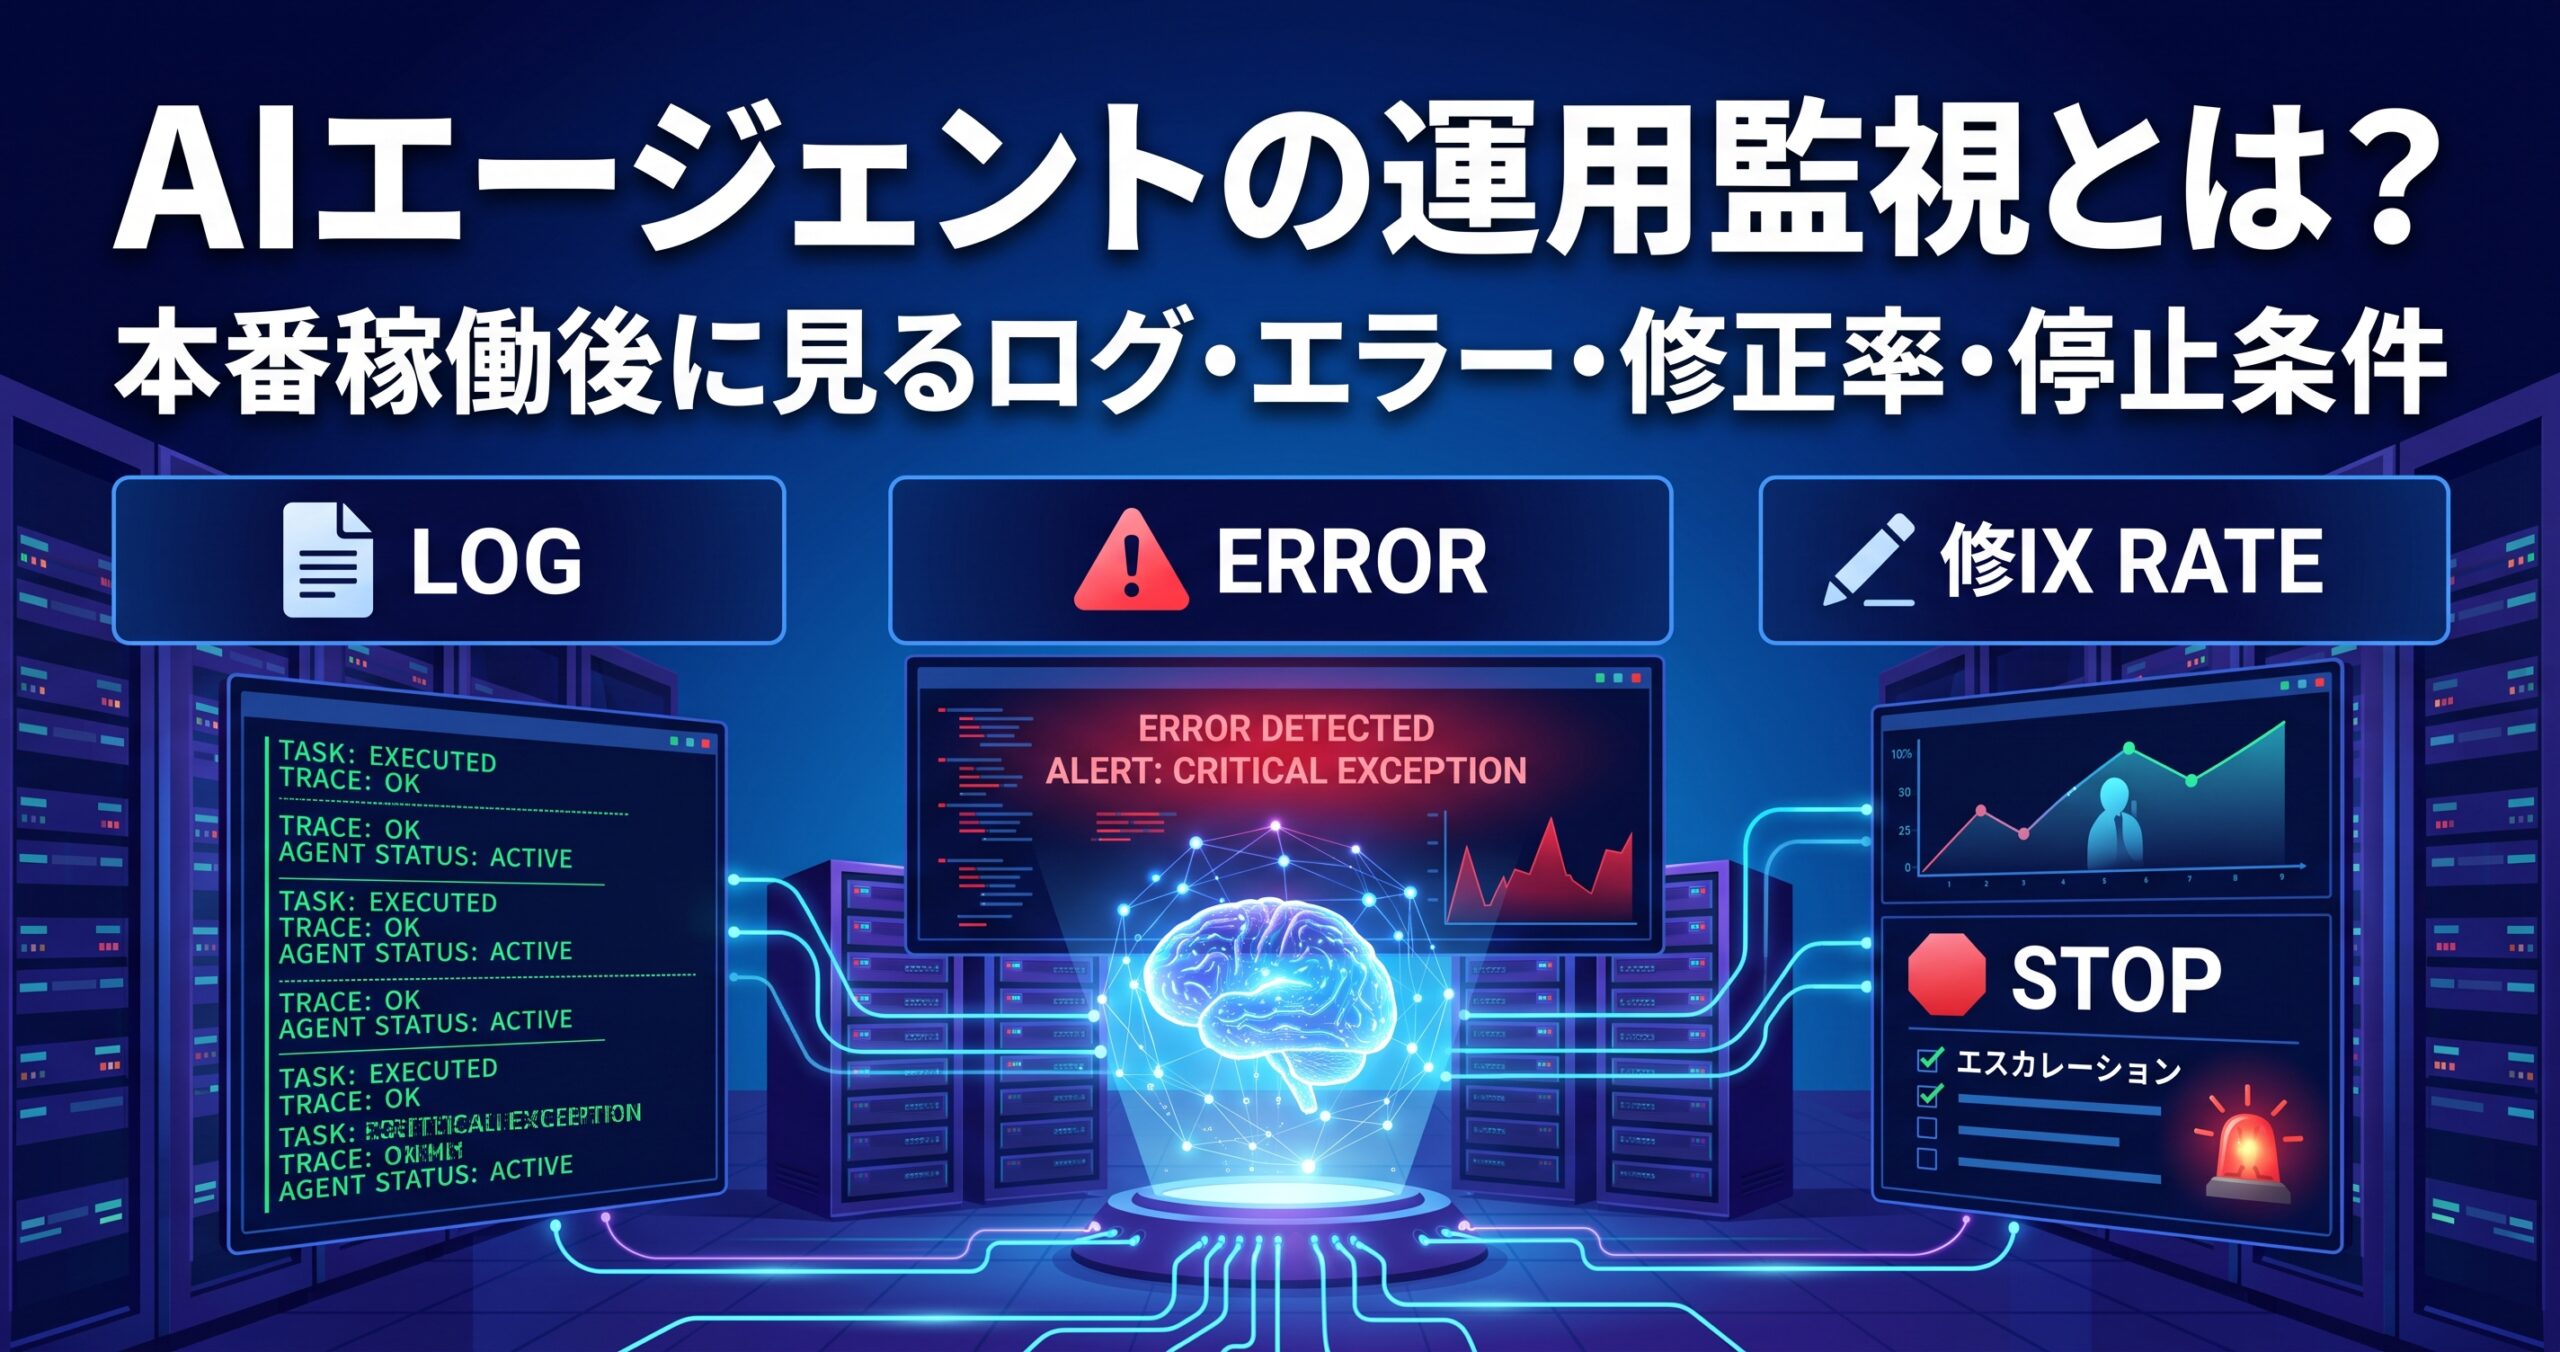
AIエージェントの運用監視とは、本番環境で実行された処理の状態・品質・異常・コスト・人の介入状況を継続的に観測し、問題発生時に原因を追跡して改善できる状態を作ることです。
通常のシステム監視では、主に可用性、エラー、レスポンスタイムなどを確認します。
AIエージェントでは、それに加えて、
- どのモデルを使ったか
- どのデータを参照したか
- どのツールを呼び出したか
- 何回再試行したか
- どこで人の承認が入ったか
- どの出力を人が修正したか
- 業務判断として採用されたか
なども確認対象になります。
つまり、「正常終了したか」だけではなく、正常終了した処理が業務として正しかったかまでを見る必要があります。
PoCの評価と本番稼働後の監視は何が違う?
PoCは「この業務で使えるか」を判断する工程、本番監視は「使い続けても問題ない状態か」を継続的に確認する工程です。
| 項目 | PoC | 本番運用監視 |
|---|---|---|
| 主な目的 | 導入可否を判断する | 品質・安全性・安定性を維持する |
| 期間 | 一定期間 | 継続 |
| データ | 限定した業務データ | 実際の利用・顧客・業務データ |
| 見るもの | 精度、工数、実現可能性 | 異常、品質変化、修正、コスト、業務結果 |
| 失敗への対応 | 開発チームが確認 | 即時対応・停止・担当者通知が必要 |
| 改善 | 本番移行判断 | 継続的な修正・再評価 |
AIエージェントの導入・PoCの進め方については、関連記事で詳しく整理しています。
AIエージェント導入の進め方|業務選定からPoC・本番運用までを整理
なぜPoC後にも継続監視が必要なのか
AIエージェントは、PoC時と本番時で入力データ・利用者・実行件数・例外条件が変わるため、一度評価して終わりにはできません。
例えば営業リサーチのAIエージェントなら、PoCでは代表的な企業だけを対象に正しく動いていても、本番では、
- 情報がほとんど公開されていない企業
- 同名企業
- 最近社名変更した企業
- 複数事業を持つ企業
- 自社の対象外企業
- 取得元データが古い企業
などが混ざります。
本番稼働では、こうした想定外の入力が蓄積されるため、AIエージェントの結果を継続的に観測する必要があります。
正常終了しても誤っている場合がある
通常のシステムでは「APIが200を返した」「処理が完了した」といった技術的な成功を監視できます。
しかしAIエージェントでは、処理自体は成功していても、
- 別会社の情報を取得した
- 古い情報を採用した
- 対象外企業を優先候補にした
- 根拠の弱い仮説を事実として出力した
- 必要な情報を見落とした
という業務上の失敗が起こり得ます。
そのため「システムエラー」と「業務品質エラー」を分けて監視します。
ログだけでなく「トレース」で実行経路を見る
複数ステップを動くAIエージェントでは、最終出力だけでなく、どの処理をどの順序で実行したかを追える状態が重要です。
例えば営業リサーチなら、
- 対象企業を受け取る
- 企業情報を検索する
- 自社データを参照する
- 対象企業か判定する
- 課題仮説を作る
- 優先度を判定する
- 人へ確認依頼する
- CRM更新候補を作る
という複数工程があります。
最終結果が誤っていた場合、「AIの回答がおかしかった」とまとめるのではなく、どの工程から誤りが発生したかを追います。
ログ・メトリクス・トレースの役割
| 種類 | 主に分かること | 例 |
|---|---|---|
| ログ | 個々の出来事 | ツール実行、エラー、承認、停止 |
| メトリクス | 全体傾向 | 成功率、エラー率、修正率、処理時間 |
| トレース | 一つの処理が通った経路 | 検索→モデル判断→ツール実行→承認 |
「エラー率が上がった」というメトリクスで異常を見つけ、対象トレースを開いて原因を確認し、個別ログを見る、という使い分けができます。
実行ログには何を残す?
AIエージェントの実行ログは、後から「何が起きたか」を説明できる粒度で設計します。
候補となる項目は次の通りです。
| 項目 | 確認できること |
|---|---|
| 実行ID | 一つの処理を識別する |
| 実行日時 | 異常発生時期を確認する |
| 対象業務 | どのワークフローか確認する |
| エージェント・設定バージョン | 変更前後を比較する |
| 利用データ | 判断に使った情報源を確認する |
| 利用ツール | どの外部処理を行ったか確認する |
| 処理結果 | 成功・失敗・保留を確認する |
| エラー・例外 | 失敗内容を分類する |
| 再試行 | 不要なループや不安定性を見る |
| 人の承認 | 誰がどこで介入したかを見る |
| 修正内容 | AI結果との違いを分析する |
| 処理時間 | 遅延を確認する |
| 利用量・コスト | 異常な実行量を確認する |
ただし、ログへ顧客情報や機密情報を無制限に保存するのではなく、監査・改善に必要な項目と保存範囲を決めます。
失敗・例外は一つの「エラー」にまとめない
改善につなげるには、失敗を原因別に分類します。
| 分類 | 例 | 主な見直し先 |
|---|---|---|
| データ不足 | 対象企業の必要情報がない | データ取得・代替処理 |
| データ不整合 | 企業名・IDが一致しない | データ整備・名寄せ |
| ツールエラー | API・外部サービスが失敗 | 再試行・フォールバック |
| モデル判断 | 誤った分類・優先順位 | プロンプト・評価条件 |
| ルール不足 | 想定外ケースで実行継続 | 停止・分岐条件 |
| 権限 | 必要処理を実行できない | アクセス設計 |
| 業務例外 | 通常フローで扱えない案件 | 人へのエスカレーション |
例えば「企業情報を取得できなかった」という結果でも、検索対象が存在しないのか、APIが落ちたのか、同名企業を特定できないのかでは改善方法が異なります。
人による修正率を見る
人がAIエージェントの結果をどの程度修正しているかは、本番品質を確認する重要な指標です。
例えば社内の管理指標として、
修正率 = 人が修正した実行数 ÷ 人が確認した実行数
のように定義できます。
ただし、数値だけを見るのではなく、修正理由も残します。
- 事実が誤っていた
- 情報が不足していた
- 判断基準が違った
- 出典が弱かった
- 対象企業ではなかった
- 表現のみ修正した
- 業務上の例外だった
修正理由によって見直す場所が変わります。
修正率が上がったら「モデル性能」だけを疑わない
修正率が増えた場合でも、原因がモデルとは限りません。
例えば、
- 入力データの品質が低下した
- 新しい顧客層へ対象を広げた
- 業務ルールが変わった
- 参照データが古くなった
- 評価担当者の基準が変わった
可能性があります。
変更履歴とトレースを合わせて原因を確認します。
「誤判断」をどう検知する?
AIエージェントでは、技術エラーとは別に「業務上の誤判断」を検知する仕組みが必要です。
例えばリード獲得エージェントなら、
| 技術的には成功 | 業務上の問題 |
|---|---|
| 企業情報取得成功 | 別企業の情報だった |
| スコア計算成功 | 対象外企業を高評価した |
| メール案生成成功 | 過去接点と矛盾していた |
| CRM登録成功 | 誤った情報を書き込んだ |
| タスク完了 | 営業担当者が使わなかった |
そのため、
- 人の承認率
- 修正率
- 差し戻し率
- 対象外判定率
- 情報欠落
- 誤ったツール利用
- 業務成果との不一致
などを対象業務に合わせて確認します。
異常値だけでなく「変化」を監視する
AIエージェントの監視では、絶対値だけでなく通常状態からの変化を見ることも重要です。
例えば、
- 修正率が急に上がった
- 再試行回数が増えた
- 平均処理時間が伸びた
- 特定ツールの失敗が増えた
- 人へのエスカレーションが増えた
- 1実行当たりコストが増えた
などです。
モデル、プロンプト、データ、API、業務条件など何かが変わった可能性を確認します。
停止・エスカレーション条件を決める
問題が起きてから「止めるべきか」を相談するのではなく、どの状態なら自動停止・人へ引き継ぐかを事前に決めます。
例えば次のように整理できます。
| 状態 | 処理 |
|---|---|
| 情報が不足 | 推測せず人へ確認 |
| 企業を一意に特定できない | 処理停止・人へ引き継ぐ |
| 外部ツールが連続失敗 | 自動処理を停止 |
| 重要データ更新 | 実行前に人の承認 |
| 高リスク判断 | 人へエスカレーション |
| 異常な実行件数 | 一時停止・運用担当へ通知 |
| 一定以上の修正率 | 自動範囲を縮小して原因確認 |
どの数値で停止するかは、業務リスクや通常時の実績によって異なります。
他社の数値をそのまま採用するのではなく、自社のベースラインを作って決めます。
AIエージェントの権限・承認・停止設計については、関連記事でも詳しく解説しています。
AIエージェントのセキュリティ対策|企業導入で確認すべき権限・データ・承認設計
アラートを重要度別に分ける
すべての異常を同じ緊急度で通知すると、運用担当者が重要な異常を見落としやすくなります。
| レベル | 例 | 対応例 |
|---|---|---|
| 情報 | 一時的な再試行 | 記録のみ |
| 注意 | 修正率・処理時間が上昇 | 担当者が確認 |
| 重大 | 連続エラー・誤った外部更新 | 即時停止・責任者通知 |
重要なのはアラート数を増やすことではなく、担当者が次の行動を判断できることです。
運用ダッシュボードで最低限確認したい指標
技術・品質・人の介入・業務成果を一つの画面で確認できると、原因を切り分けやすくなります。
| 領域 | 監視候補 |
|---|---|
| 実行 | 実行数、成功数、停止数 |
| エラー | エラー率、例外分類、再試行 |
| 品質 | 誤判断、情報欠落、評価スコア |
| 人 | 承認率、修正率、差し戻し率 |
| 速度 | 処理時間、承認待ち時間 |
| コスト | 実行コスト、成功タスク当たりコスト |
| 業務 | 採用率、処理完了率、対象業務KPI |
すべてを一度に監視する必要はありません。
対象業務で「何が壊れたら困るか」「何が悪化したら改善が必要か」から指標を絞ります。
工数・利用・事業価値まで含む効果測定については、次の記事で整理しています。
AIエージェントのROIはどう測る?工数削減だけで終わらない効果測定の考え方
運用監視から定期改善へつなげる
監視の目的は異常を見つけることではなく、原因を修正し、次の実行品質を改善することです。
改善サイクルは次のように整理できます。
- 実行ログ・トレースを収集する
- エラー・人の修正・誤判断を分類する
- 原因候補を特定する
- プロンプト・データ・ルール・ツール・ワークフローを修正する
- 過去の失敗事例で再テストする
- 限定的に本番反映する
- 指標が改善したか監視する
人の修正を改善データとして残す
AIエージェントが出した結果を人が直した場合、「修正後の正しい答え」だけを保存するのではなく、なぜ修正したかを残します。
例えば、
- 参照データが古かった
- 企業判定ルールが足りなかった
- 文脈を誤解していた
- CRMの既存情報を見落としていた
- 人が判断すべき例外案件だった
と分類します。
それぞれ、データ、判断ルール、ワークフロー、エスカレーション条件など改善箇所が異なります。
変更したら回帰テストする
一つのエラーを修正しても、別のケースで品質が下がる可能性があります。
そのため、過去に正常だったケースと失敗したケースを評価用データとして残し、変更前後を比較します。
本番環境へ直接大きな変更を入れるのではなく、限定範囲で確認してから広げます。
AIエージェントのワークフロー設計と運用監視を接続する
監視しやすいAIエージェントを作るには、最初から業務を工程へ分解しておくことが重要です。
例えば「営業リサーチAI」という一つの処理だけで記録すると、問題発生時にどこを修正すればよいか分かりません。
一方、
検索 → データ取得 → 対象判定 → 仮説生成 → 優先度判定 → 人の承認 → CRM反映
と分けていれば、失敗工程を特定しやすくなります。
AIエージェントのワークフロー分解については、次の記事で詳しく解説しています。
AIエージェントのワークフロー設計|調査・判断・実行をどう分けるべきか
IMMNの一次情報から考える本番運用のポイント
AIエージェントの価値は、一度自動化できたことではなく、同じ業務を再現性を持って継続できる状態にすることで生まれます。
インティメート・マージャーが関わってきたAI・データ活用の議論でも、既存の業務フローを整理し、その一部をAIへ移しながら、必要なデータやセキュリティ基準まで含めて業務そのものを設計する考え方が扱われています。
BtoBのリード獲得でも、AIエージェントを使って企業リサーチや優先順位付けを行う場合、単にリード数を増やすのではなく、同じ条件で一定品質の結果が出るプロセスを作ることが重要です。
本番運用では、この「再現性」をログ・修正率・誤判断・業務成果から継続的に確認します。
AIエージェント運用監視の実務チェックリスト
| 確認項目 | なぜ重要か | 不足時の見直し |
|---|---|---|
| 実行IDで一件ずつ追跡できる | 問題処理を再現するため | ログ設計を見直す |
| モデル・ツール・設定版を記録している | 変更前後を比較するため | バージョン情報を追加する |
| エラーを原因別に分類している | 改善箇所を特定するため | 例外カテゴリを作る |
| 人の修正率を把握している | 隠れた確認工数を見るため | 修正有無と理由を保存する |
| 業務上の誤判断を記録している | 技術的成功だけで判断しないため | 業務品質評価を追加する |
| 再試行・ループを監視している | 不安定性・コスト増を見つけるため | 回数上限・終了条件を設定する |
| 停止条件が決まっている | 重大な誤実行を広げないため | 自動停止条件を定義する |
| エスカレーション先が決まっている | 異常後の対応を早めるため | 担当・責任者を明文化する |
| 変更後に回帰テストしている | 別ケースの品質悪化を防ぐため | 過去ケースを評価セット化する |
| 定期的に指標を見直している | 業務変化へ対応するため | 月次等で監視項目をレビューする |
まとめ|本番運用では「動いているか」ではなく「正しく動き続けているか」を見る
AIエージェントを本番導入した後は、「実行できたか」だけを監視しても十分ではありません。
少なくとも、
- どの処理を行ったか
- どこでエラー・例外が起きたか
- 人がどの程度修正しているか
- 業務上の誤判断が起きていないか
- 再試行やコストが増えていないか
- いつ停止・人へ引き継ぐか
- 修正後に品質が改善したか
を確認できる状態を作ります。
PoCは「使えそうか」を確認する工程ですが、本番運用では「正しく動き続けているか」を継続して確認する運用設計が必要です。
まず現在動いているAIエージェントについて、失敗した一件を後から「どのデータを使い、どのツールを実行し、どこで判断を誤ったか」まで追えるか確認してみてください。
AIエージェントを、実際のリード獲得・営業業務へどう組み込むか知りたい方へ
運用監視の設計には、「そもそもAIエージェントにどの業務を任せるのか」という業務フローの理解が欠かせません。
アーカイブ配信「AIエージェントで実現する自動リサーチ・リード獲得の仕組み」では、データとAIを活用しながら企業リサーチ、リード獲得、営業業務へ接続する考え方を紹介しています。
AIエージェントの運用監視に関するよくある質問
AIエージェントの運用監視では何を確認すればよいですか?
実行ログ、トレース、エラー・例外、人の修正率、誤判断、処理時間、コスト、停止・エスカレーション状況などを対象業務に合わせて確認します。
ログとトレースは何が違いますか?
ログは個々の出来事、トレースは一つの業務処理が複数工程をどのように通過したかを追う情報です。AIエージェントでは両方を組み合わせると原因を特定しやすくなります。
AIエージェントが正常終了していれば監視は不要ですか?
不要とはいえません。技術的に正常終了していても、誤った企業情報や業務判断を出力している可能性があるため、業務品質も確認します。
修正率はどのくらいなら問題ですか?
一律の基準はありません。自社の通常値を作り、急激な変化や業務上許容できない修正負荷が生じていないかを確認します。
AIエージェントはどのタイミングで停止すべきですか?
情報不足、連続エラー、重要データへの誤操作、異常な実行量など、失敗時の影響が大きい状態を事前に停止条件として定義します。
AIエージェントの監視は開発部門だけで行えばよいですか?
技術監視だけでは不足します。業務上の誤判断や修正理由は営業・マーケティングなど業務担当者でなければ判断できないため、技術担当と業務担当の両方が関与する設計が必要です。
AIエージェントは一度改善すれば監視項目を減らしてもよいですか?
安定した項目は見直せますが、モデル・データ・ツール・業務条件が変われば品質も変化する可能性があります。変更内容とリスクに応じて監視項目を定期的に見直します。

「IMデジタルマーケティングニュース」編集者として、最新のトレンドやテクニックを分かりやすく解説しています。業界の変化に対応し、読者の成功をサポートする記事をお届けしています。