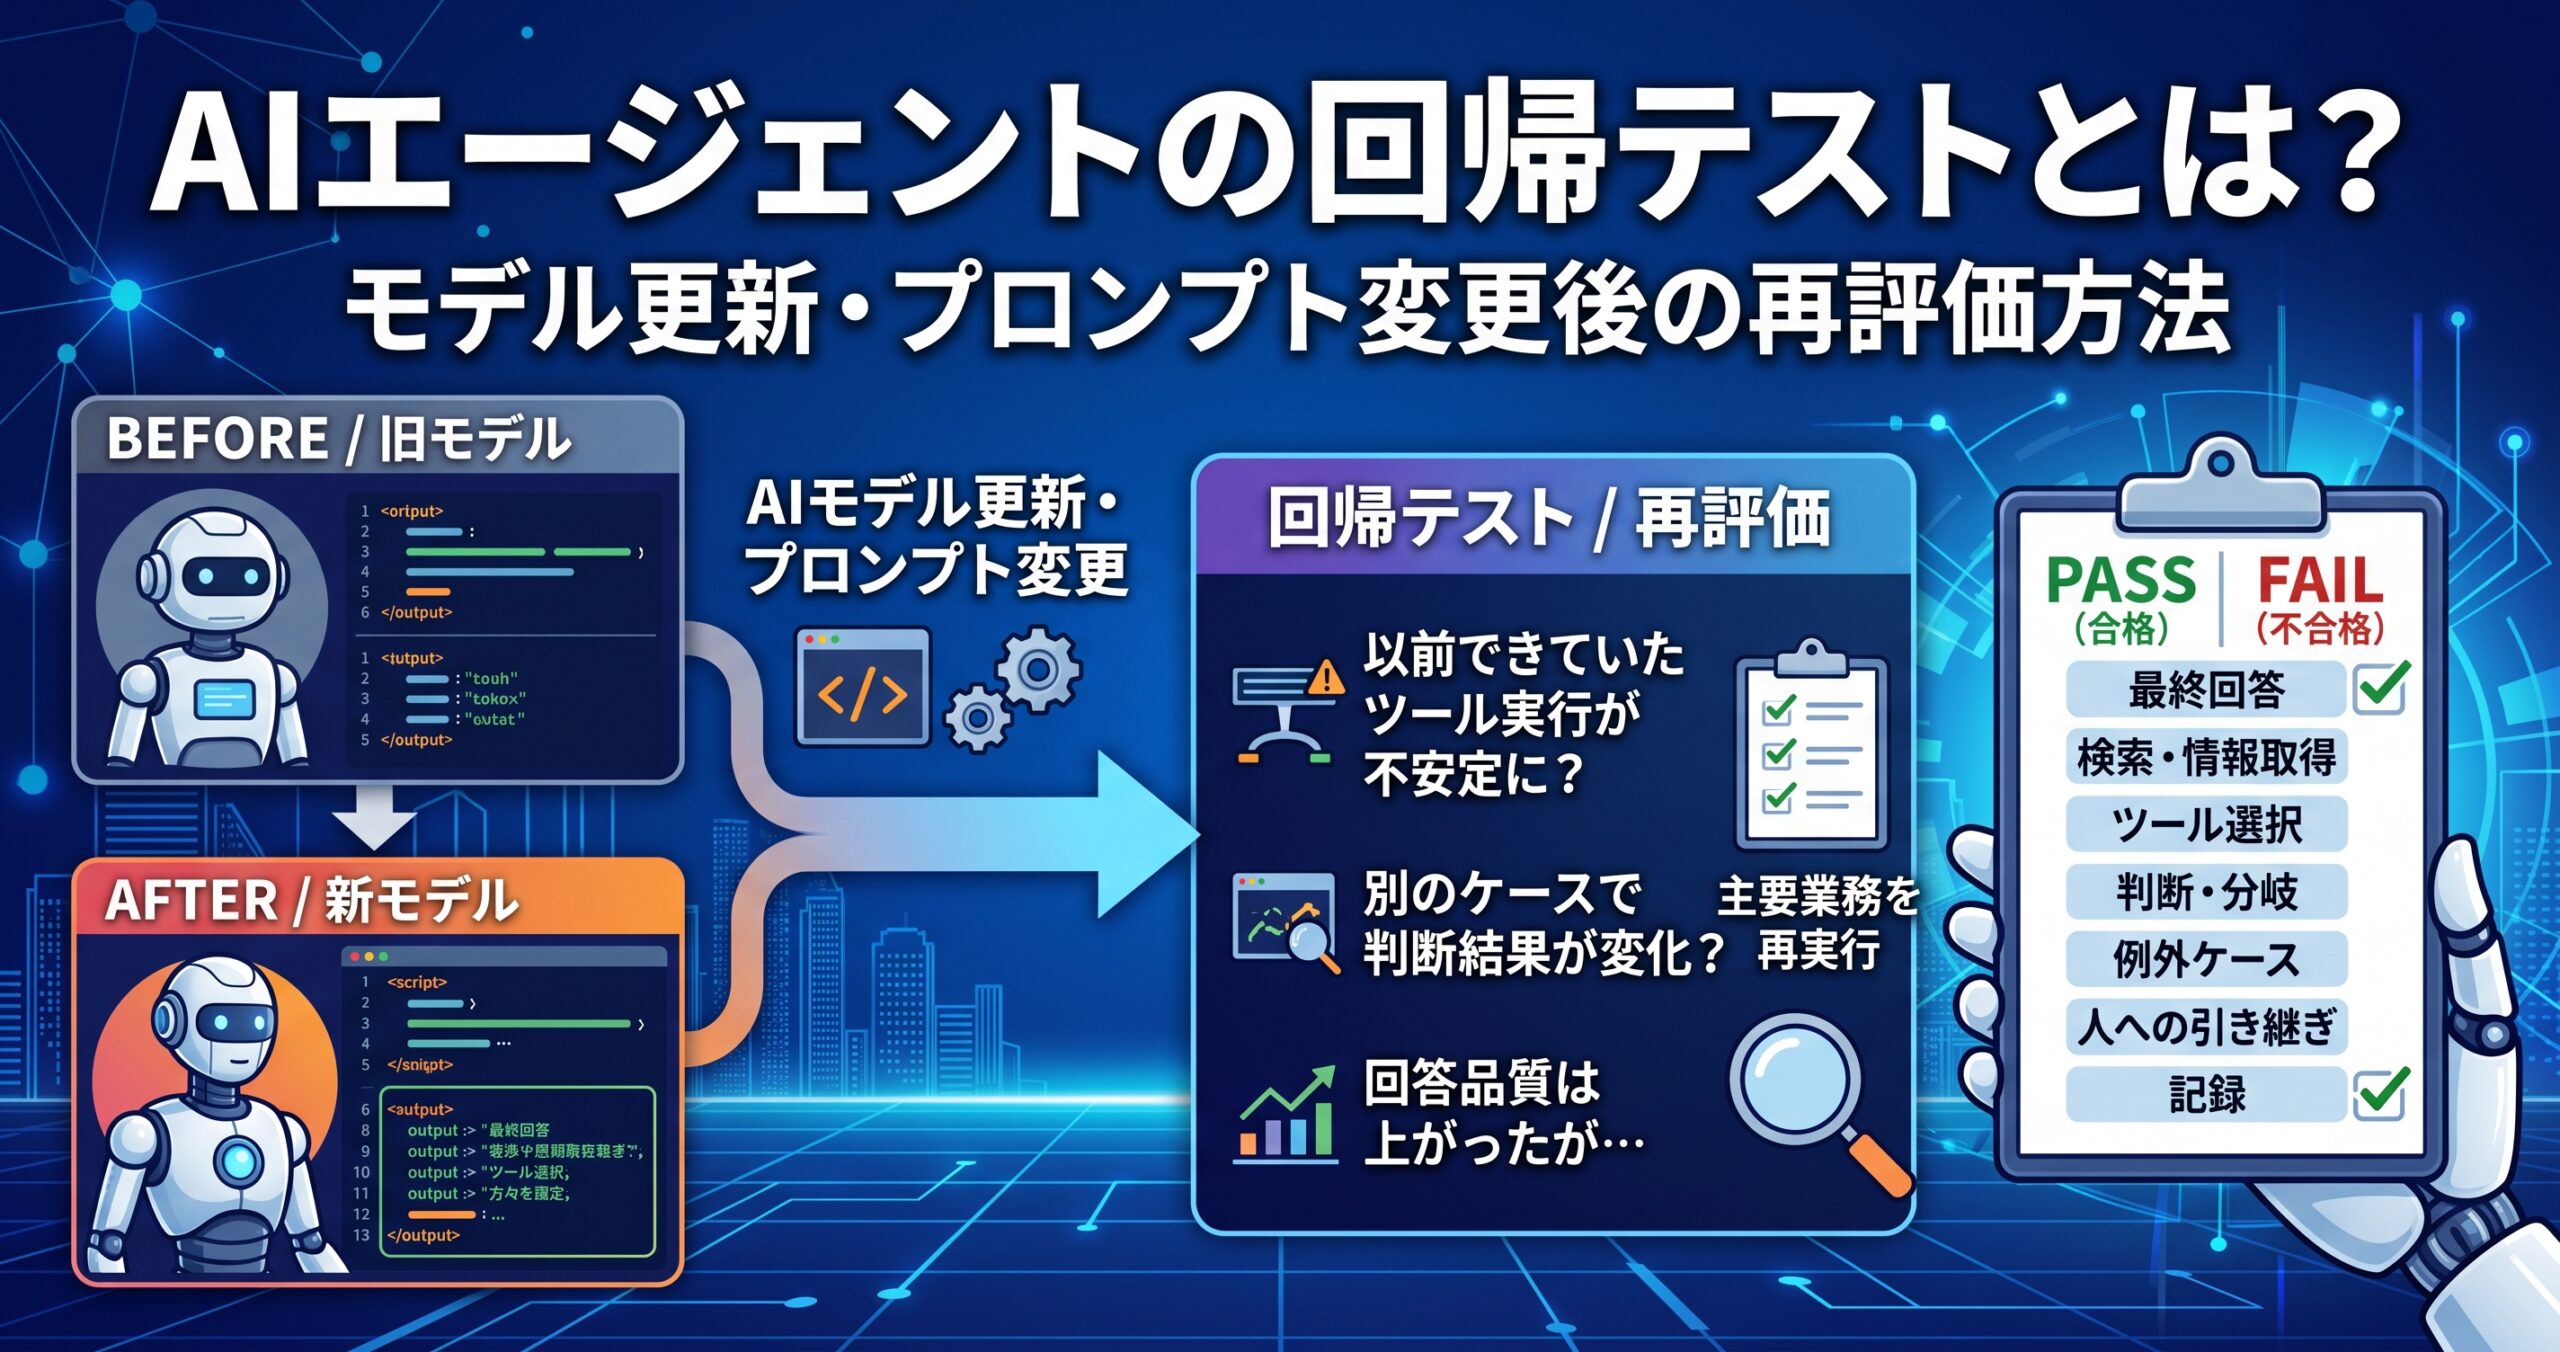
「新しいAIモデルへ切り替えたら回答品質は上がったのに、以前できていたツール実行が不安定になった」「プロンプトを一か所修正しただけなのに、別のケースで判断結果が変わった」「問題を直したが、本当に直ったのか数件試しただけで本番へ戻している」。
AIエージェントを本番運用すると、このような変更管理の課題が出てきます。
結論から言うと、モデル・プロンプト・知識データ・ツール・ルールなどを変更した場合は、変更した箇所だけではなく、これまで正常に動いていた主要業務も同じテストセットで再評価することが重要です。
この確認を回帰テスト、またはリグレッションテストと呼びます。
AIエージェントでは最終回答だけでなく、検索、ツール選択、判断、分岐、人へのエスカレーションなど複数工程があります。そのため「回答文が良くなった」だけでは本番反映の判断として十分ではありません。
本記事では、AIモデル比較ではなく、稼働中のAIエージェントへ変更を加えるときの回帰テストを、基準テストケース、期待結果、変更前後比較、例外ケース、本番反映基準、記録まで整理します。
この記事の要点
- 回帰テストは、変更によって「以前できていたこと」が壊れていないかを確認するテストです。
- モデル変更だけでなく、プロンプト、ナレッジ、ツール、ルーティング、ガードレール変更も再評価のトリガーになります。
- 生成AIでは出力文章を完全一致させるより、「何を満たせば合格か」という期待結果・評価基準を固定します。
- 正常ケースだけでなく、情報不足、外部ツール失敗、同名企業など実務上の例外ケースも残します。
- 本番で発生した失敗は修正して終わらせず、回帰テストセットへ追加し、同じ問題の再発を確認できる状態にします。
- AIエージェントの回帰テストとは?
- AIモデル評価と回帰テストの違い
- モデル更新で何が変わる?
- 回帰テストはモデル変更以外でも実施する
- 基準となるテストケースを固定する
- 期待結果と合格基準を先に定義する
- 変更前のベースラインを残す
- 変更前後を同じ条件で比較する
- 同じ入力でも複数回確認する
- 例外ケース・失敗ケースを残す
- AIエージェントは最終回答だけでなく途中工程もテストする
- 本番反映の判断基準を変更前に決める
- 変更を一度に大きく入れない
- テスト結果と変更履歴を記録する
- 本番障害を回帰テストへ戻す
- IMMNの一次情報から考える回帰テストの役割
- AIエージェント回帰テストの実務チェックリスト
- まとめ|モデル更新は「最新版へ置き換える作業」ではなく変更管理として扱う
- AIエージェントの回帰テストに関するよくある質問
AIエージェントの回帰テストとは?
AIエージェントの回帰テストとは、モデル・プロンプト・ツール等を変更した後に、これまで正常に動いていた業務や判断が劣化していないかを再確認するテストです。
例えば営業リサーチエージェントの企業判定精度を改善するため、モデルを変更したとします。
対象企業の判定精度が改善していても、
- 企業情報の検索
- 同名企業の識別
- CRM情報の取得
- 対象外企業の除外
- 情報不足時の停止
- 人への確認依頼
など、変更目的とは別の工程が以前より悪化している可能性があります。
そのため、変更した機能の確認だけでなく、既存の重要ケースを再実行します。
AIモデル評価と回帰テストの違い
AIモデル評価は「どれを採用するか」、回帰テストは「変更しても既存業務を維持できるか」を確認する工程です。
| 項目 | AIモデル評価 | AIエージェントの回帰テスト |
|---|---|---|
| 主な目的 | 候補モデルを比較する | 変更後の品質劣化を検知する |
| タイミング | 新規導入・モデル選定 | 本番システム変更前 |
| 比較対象 | モデルAとモデルB | 変更前と変更後 |
| 基準 | 業務要件 | 既存の合格基準・ベースライン |
| 主な結果 | 採用モデル | リリース/修正/ロールバック判断 |
生成AIモデルそのものの評価方法については、関連記事で詳しく解説しています。
生成AIモデルはどう評価する?ベンチマークだけに頼らない企業向け選定方法
モデル更新で何が変わる?
モデルを変更すると、文章品質だけでなく、指示遵守、ツール選択、情報取得、例外処理なども変化する可能性があります。
AIエージェントはモデルだけで構成されているわけではありません。
実際には、
モデル + プロンプト + データ + 検索 + ツール + ルール + ワークフロー
が組み合わさって一つの業務システムとして動きます。
したがって「新しいモデルのベンチマークが高かった」という理由だけでは、本番システムの品質向上を判断できません。
モデル変更後に確認したい代表例
- 指定フォーマットを守れるか
- 必要な情報を取得できるか
- 正しいツールを選べるか
- ツールへ正しい引数を渡せるか
- 根拠がない場合に推測せず止まれるか
- 人へ確認すべきケースを正しく判断できるか
- 不要な再試行・ループが増えていないか
- 処理時間・コストが大きく悪化していないか
回帰テストはモデル変更以外でも実施する
再テストのトリガーは、モデル更新だけではありません。AIエージェントの挙動へ影響する変更を対象にします。
| 変更 | 起こり得る影響 | 確認例 |
|---|---|---|
| モデル変更 | 回答・判断・ツール利用の変化 | 主要業務を再実行 |
| プロンプト変更 | 別ケースの指示遵守が悪化 | 変更箇所以外の主要ケース |
| ナレッジ更新 | 検索・根拠選択が変化 | 引用・情報選択 |
| ツール追加・変更 | 誤ったツール選択 | 選択・引数・失敗時動作 |
| ルーティング変更 | 誤ったエージェントへ引き継ぐ | 分岐・ハンドオフ |
| ガードレール変更 | 正常処理まで止める可能性 | 許可・拒否の両方 |
| 業務ルール変更 | 旧ルールとの矛盾 | 新旧ルール境界ケース |
変更内容から影響範囲を考え、最低限のテストだけに絞るのではなく、業務上重要なコアケースも合わせて確認します。
基準となるテストケースを固定する
回帰テストを成立させるには、「変更するたびに違う質問を試す」のではなく、比較基準となるテストセットを残します。
例えば営業リサーチエージェントなら、次のケースを固定できます。
| ケース | 確認すること |
|---|---|
| 一般的な対象企業 | 通常業務を完了できる |
| 対象外企業 | 正しく除外できる |
| 同名企業 | 別企業を誤認しない |
| 公開情報が少ない企業 | 推測せず不足を示せる |
| 過去接点がある企業 | 既存情報と矛盾しない |
| ツールエラー | 再試行または人へ引き継げる |
| 判断困難 | 無理に結論を出さず停止できる |
本番で起きた失敗をテストケースへ追加する
テストセットは最初から完成させる必要はありません。
本番で、
- 同名企業を取り違えた
- 対象外企業を高スコアにした
- 古い情報を優先した
- 情報不足なのに推測した
といった失敗が発生したら、そのケースを保存します。
修正後は同じケースを実行し、さらに今後の変更でも再発していないか確認します。
期待結果と合格基準を先に定義する
生成AIでは文章そのものを完全一致させるより、「何を満たせば業務上合格なのか」を固定する方が実務的です。
例えば企業リサーチ結果なら、期待結果を次のように分けます。
| 評価項目 | 合格条件例 |
|---|---|
| 企業特定 | 正しい法人を特定している |
| 根拠 | 判断根拠となる情報源が確認できる |
| 対象判定 | 定義した条件に沿って判定している |
| 情報不足 | 不足時に推測せず明示する |
| ツール選択 | 許可された適切なツールを利用する |
| 人への引き継ぎ | 判断困難時に指定フローへ移る |
| 形式 | 指定した出力項目を満たす |
文章表現が少し異なっていても、必要条件を満たしていれば合格とする方法があります。
変更前のベースラインを残す
回帰を判断するには、変更後だけでなく、変更前の結果を残しておきます。
最低限、
- システム・モデルのバージョン
- プロンプト・設定バージョン
- テストセット
- 合格条件
- テスト日時
- 各ケースの結果
- 全体の合格率
- 人による修正量
- 処理時間・コスト
を残します。
これにより「新しい方が何となく良い」という評価ではなく、どの項目が改善し、どの項目が悪化したかを比較できます。
変更前後を同じ条件で比較する
変更の評価では、可能な範囲でテストデータ・プロンプト・評価基準を揃えます。
| 評価項目 | 変更前 | 変更後 | 判定 |
|---|---|---|---|
| コアケース合格 | 記録 | 記録 | 改善/維持/劣化 |
| ツール利用 | 記録 | 記録 | 改善/維持/劣化 |
| 例外処理 | 記録 | 記録 | 改善/維持/劣化 |
| 人の修正 | 記録 | 記録 | 増加/維持/減少 |
| 処理時間 | 記録 | 記録 | 増加/維持/減少 |
| 実行コスト | 記録 | 記録 | 増加/維持/減少 |
改善目的の指標だけを見るのではなく、以前正常だった重要指標が落ちていないかを確認します。
同じ入力でも複数回確認する
生成AIでは出力にばらつきがあるため、一回成功しただけで回帰なしと判断しない方がよいケースがあります。
特に、
- 判断が曖昧なケース
- ツール選択が複数考えられるケース
- 長いコンテキストを扱うケース
- 高リスクな判断
は複数回実行し、重要な判断が大きく変わらないか確認します。
実行回数を一律に決めるのではなく、業務リスクと出力のばらつきに応じて設計します。
例外ケース・失敗ケースを残す
回帰テストでは、正常ケースだけでなく「うまくいかないと困るケース」を重視します。
例えば、
- 必要データが存在しない
- 複数データが矛盾している
- 外部APIが失敗する
- 同じ企業名が複数存在する
- 権限がない
- 入力フォーマットが崩れている
- 対象外の依頼を受ける
- 危険な操作を要求される
といったケースです。
本番で問題になったケースは「直したから削除」ではなく、将来の変更でも壊れていないか確認する回帰テストとして残します。
AIエージェントは最終回答だけでなく途中工程もテストする
AIエージェントでは、最終成果物が合っていても、不適切な経路を通っている場合があります。
例えば最終企業情報が正しくても、途中で、
- 不要な検索を大量に実行した
- 本来使ってはいけないデータへアクセスした
- 誤ったツールを呼んだ後に偶然修正された
- 同じ処理を複数回実行した
のであれば、本番システムとしては改善余地があります。
そのため回帰テストでは、
| 評価対象 | 確認すること |
|---|---|
| 最終結果 | 業務目的を達成したか |
| 検索・情報取得 | 適切な情報を使ったか |
| ツール | 正しいツール・引数か |
| ルーティング | 適切な工程へ進んだか |
| 承認 | 必要な人の確認を通ったか |
| 停止 | 判断できない場合に止まったか |
| 再試行 | 不要なループがないか |
を確認します。
AIエージェントの業務工程そのものを整理する方法は、関連記事で詳しく解説しています。
AIエージェントのワークフロー設計|調査・判断・実行をどう分けるべきか
本番反映の判断基準を変更前に決める
テスト結果を見てから合格基準を決めるのではなく、変更前に「何を満たせば本番へ出せるか」を決めます。
例えば、
- 重大ケースはすべて合格する
- 既存コアケースを悪化させない
- 新しく修正した問題が再現しない
- 禁止されたツール・操作を実行しない
- 人の修正負荷が許容範囲を超えない
- 処理時間・コストが許容範囲内
といった条件です。
平均点だけでリリースを決めない
全体合格率が改善していても、重要顧客への誤送信など「失敗すると影響が大きいケース」が悪化しているなら、本番反映を止める判断が必要です。
そのため、
- 必ず通すコアケース
- 一般品質を見るケース
- 例外・境界ケース
を分けて管理します。
変更を一度に大きく入れない
モデル、プロンプト、検索、ツール、ルールを同時に変えると、品質が変わった原因を特定しにくくなります。
可能な範囲で変更単位を分け、変更内容を記録します。
例えば、
- 新モデルで既存テストを実行する
- 問題がなければプロンプト変更を加える
- 再度回帰テストする
- 限定的に本番適用する
- 運用ログを確認して範囲を広げる
という進め方です。
大きな変更では、問題発生時に以前の構成へ戻せるよう、モデル・プロンプト・設定のバージョンも残します。
テスト結果と変更履歴を記録する
回帰テストは「実施した」という記録だけでなく、何を変え、何が変化し、なぜリリースしたのかが後から追える状態にします。
| 記録項目 | 内容 |
|---|---|
| 変更ID | 変更を一意に識別 |
| 変更内容 | モデル、プロンプト、ツール等 |
| 変更理由 | 何を改善するためか |
| 対象バージョン | 変更前・変更後 |
| テストセット | 実行したケース一覧 |
| 結果 | 合格・失敗・要確認 |
| 劣化項目 | 以前より悪くなった項目 |
| 判定 | リリース・修正・見送り |
| 承認者 | 本番反映を判断した担当 |
モデルを再度更新するときにも、過去の判断基準や失敗履歴を再利用できます。
本番障害を回帰テストへ戻す
回帰テストはリリース前だけの作業ではなく、本番運用で見つかった問題を次回の変更管理へ戻す循環が重要です。
例えば、
本番で誤判定 → 原因を調査 → 修正 → 失敗ケースをテストセットへ追加 → 修正確認 → 次回変更でも再実行
という流れを作ります。
これにより「同じ種類の事故を修正のたびに繰り返す」状態を減らしやすくなります。
IMMNの一次情報から考える回帰テストの役割
AIエージェントは、モデル単体ではなく既存業務フローの一部として導入されます。そのため、変更テストでもAIの回答だけを見るのではなく、業務全体への影響を確認する必要があります。
インティメート・マージャーのAI・データ活用に関する議論でも、AIエージェント導入は既存業務フローの一部を自動化するものとして整理され、データの持ち方、利用するAIツール、セキュリティ基準なども合わせて設計することが論点になっています。
この考え方を変更管理へ当てはめると、モデルだけを入れ替えて評価するのでは不十分です。
例えば営業リサーチエージェントなら、
モデル → データ取得 → 企業判定 → ツール利用 → 人の確認 → 営業への引き渡し
という業務全体で、変更前後に問題がないか確認します。
AIエージェント回帰テストの実務チェックリスト
| 確認項目 | なぜ重要か | 不足時の対応 |
|---|---|---|
| 変更内容を特定している | 影響範囲を考えるため | モデル・プロンプト等を分けて記録 |
| コアテストを固定している | 変更前後を比較するため | 主要業務をテストセット化 |
| 期待結果を定義している | 感覚評価を避けるため | 合格条件を明文化 |
| 変更前結果を残している | 回帰を検知するため | ベースラインを保存 |
| 例外ケースを含めている | 本番事故を減らすため | 過去失敗を追加 |
| 途中工程を評価している | 偶然正しい出力を見抜くため | ツール・分岐・承認も確認 |
| 重要ケースを別管理している | 平均スコアだけで判断しないため | Must-passケースを設定 |
| 本番反映条件を事前定義している | 都合のよい判定を避けるため | リリースゲートを決める |
| 変更履歴を残している | 問題時に原因を追うため | バージョンを管理 |
| 本番失敗をテストへ戻している | 同じ問題の再発を確認するため | 失敗ケースを恒久テスト化 |
まとめ|モデル更新は「最新版へ置き換える作業」ではなく変更管理として扱う
AIエージェントで新しいモデルが利用できるようになっても、単純に最新版へ切り替えればよいとは限りません。
本番業務では、
- モデル
- プロンプト
- データ
- ツール
- ルーティング
- 承認・停止条件
が組み合わさって動いているからです。
変更を入れるときは、
変更理由を決める → ベースラインを残す → 同じテストセットを実行する → 例外ケースを見る → 変更前後を比較する → リリース基準で判断する → 本番失敗を次のテストへ戻す
という変更管理の流れを作ります。
重要なのは、最新モデルを使うこと自体ではありません。
変更後も、自社の重要業務が必要な品質で動き続けることです。
AIエージェントを実際のリード獲得業務へどう組み込むか知りたい方へ
回帰テストを設計するには、AIエージェントが企業リサーチ、判断、営業への引き渡しをどのような業務フローで行うのかを理解しておく必要があります。
アーカイブ配信「AIエージェントで実現する自動リサーチ・リード獲得の仕組み」では、データとAIを使った企業リサーチやリード獲得の設計を紹介しています。
AIエージェントの回帰テストに関するよくある質問
AIエージェントの回帰テストとは何ですか?
モデル・プロンプト・ツール等を変更した後に、それまで正常だった主要業務や例外処理が悪化していないか再確認するテストです。
モデルを更新したら必ず再テストした方がよいですか?
本番業務へ影響するモデル変更であれば、既存の評価セットで再確認できる運用を推奨します。影響範囲・業務リスクに応じてテスト範囲を決めます。
プロンプトを少し修正しただけでも回帰テストは必要ですか?
重要業務では確認した方が安全です。特定ケースを改善する変更が、別ケースの指示遵守や判断へ影響する可能性があるためです。
生成AIでは毎回答えが違いますが、どう合否を判断しますか?
文章の完全一致ではなく、事実性、必要項目、ツール選択、禁止事項、タスク完了など業務上の合格条件を定義して評価します。
回帰テストでは何件のテストケースが必要ですか?
一律の件数では決められません。まず業務上必ず守るコアケースを揃え、運用中に発生した失敗・例外を継続的に追加します。
回帰テストと本番監視の違いは何ですか?
回帰テストは主に変更を本番へ反映する前の品質確認、本番監視は稼働後の実データで品質や異常を継続観測する工程です。両方を接続して運用します。
AIで回帰テストの採点も自動化できますか?
一部は可能です。形式・正解が明確な項目は自動評価しやすく、文章品質等はLLM評価も利用できます。ただし重要な判断では人の確認と評価基準の検証を残します。

「IMデジタルマーケティングニュース」編集者として、最新のトレンドやテクニックを分かりやすく解説しています。業界の変化に対応し、読者の成功をサポートする記事をお届けしています。