「同じ企業がCRMに複数登録されている」「展示会、ウェビナー、資料請求で同じ担当者が別リードになっている」「スコアは高いのに、営業が確認すると過去の行動を重複カウントしていた」。
BtoBマーケティングでは、リードを集めるほど、このようなデータ品質の問題が起こりやすくなります。
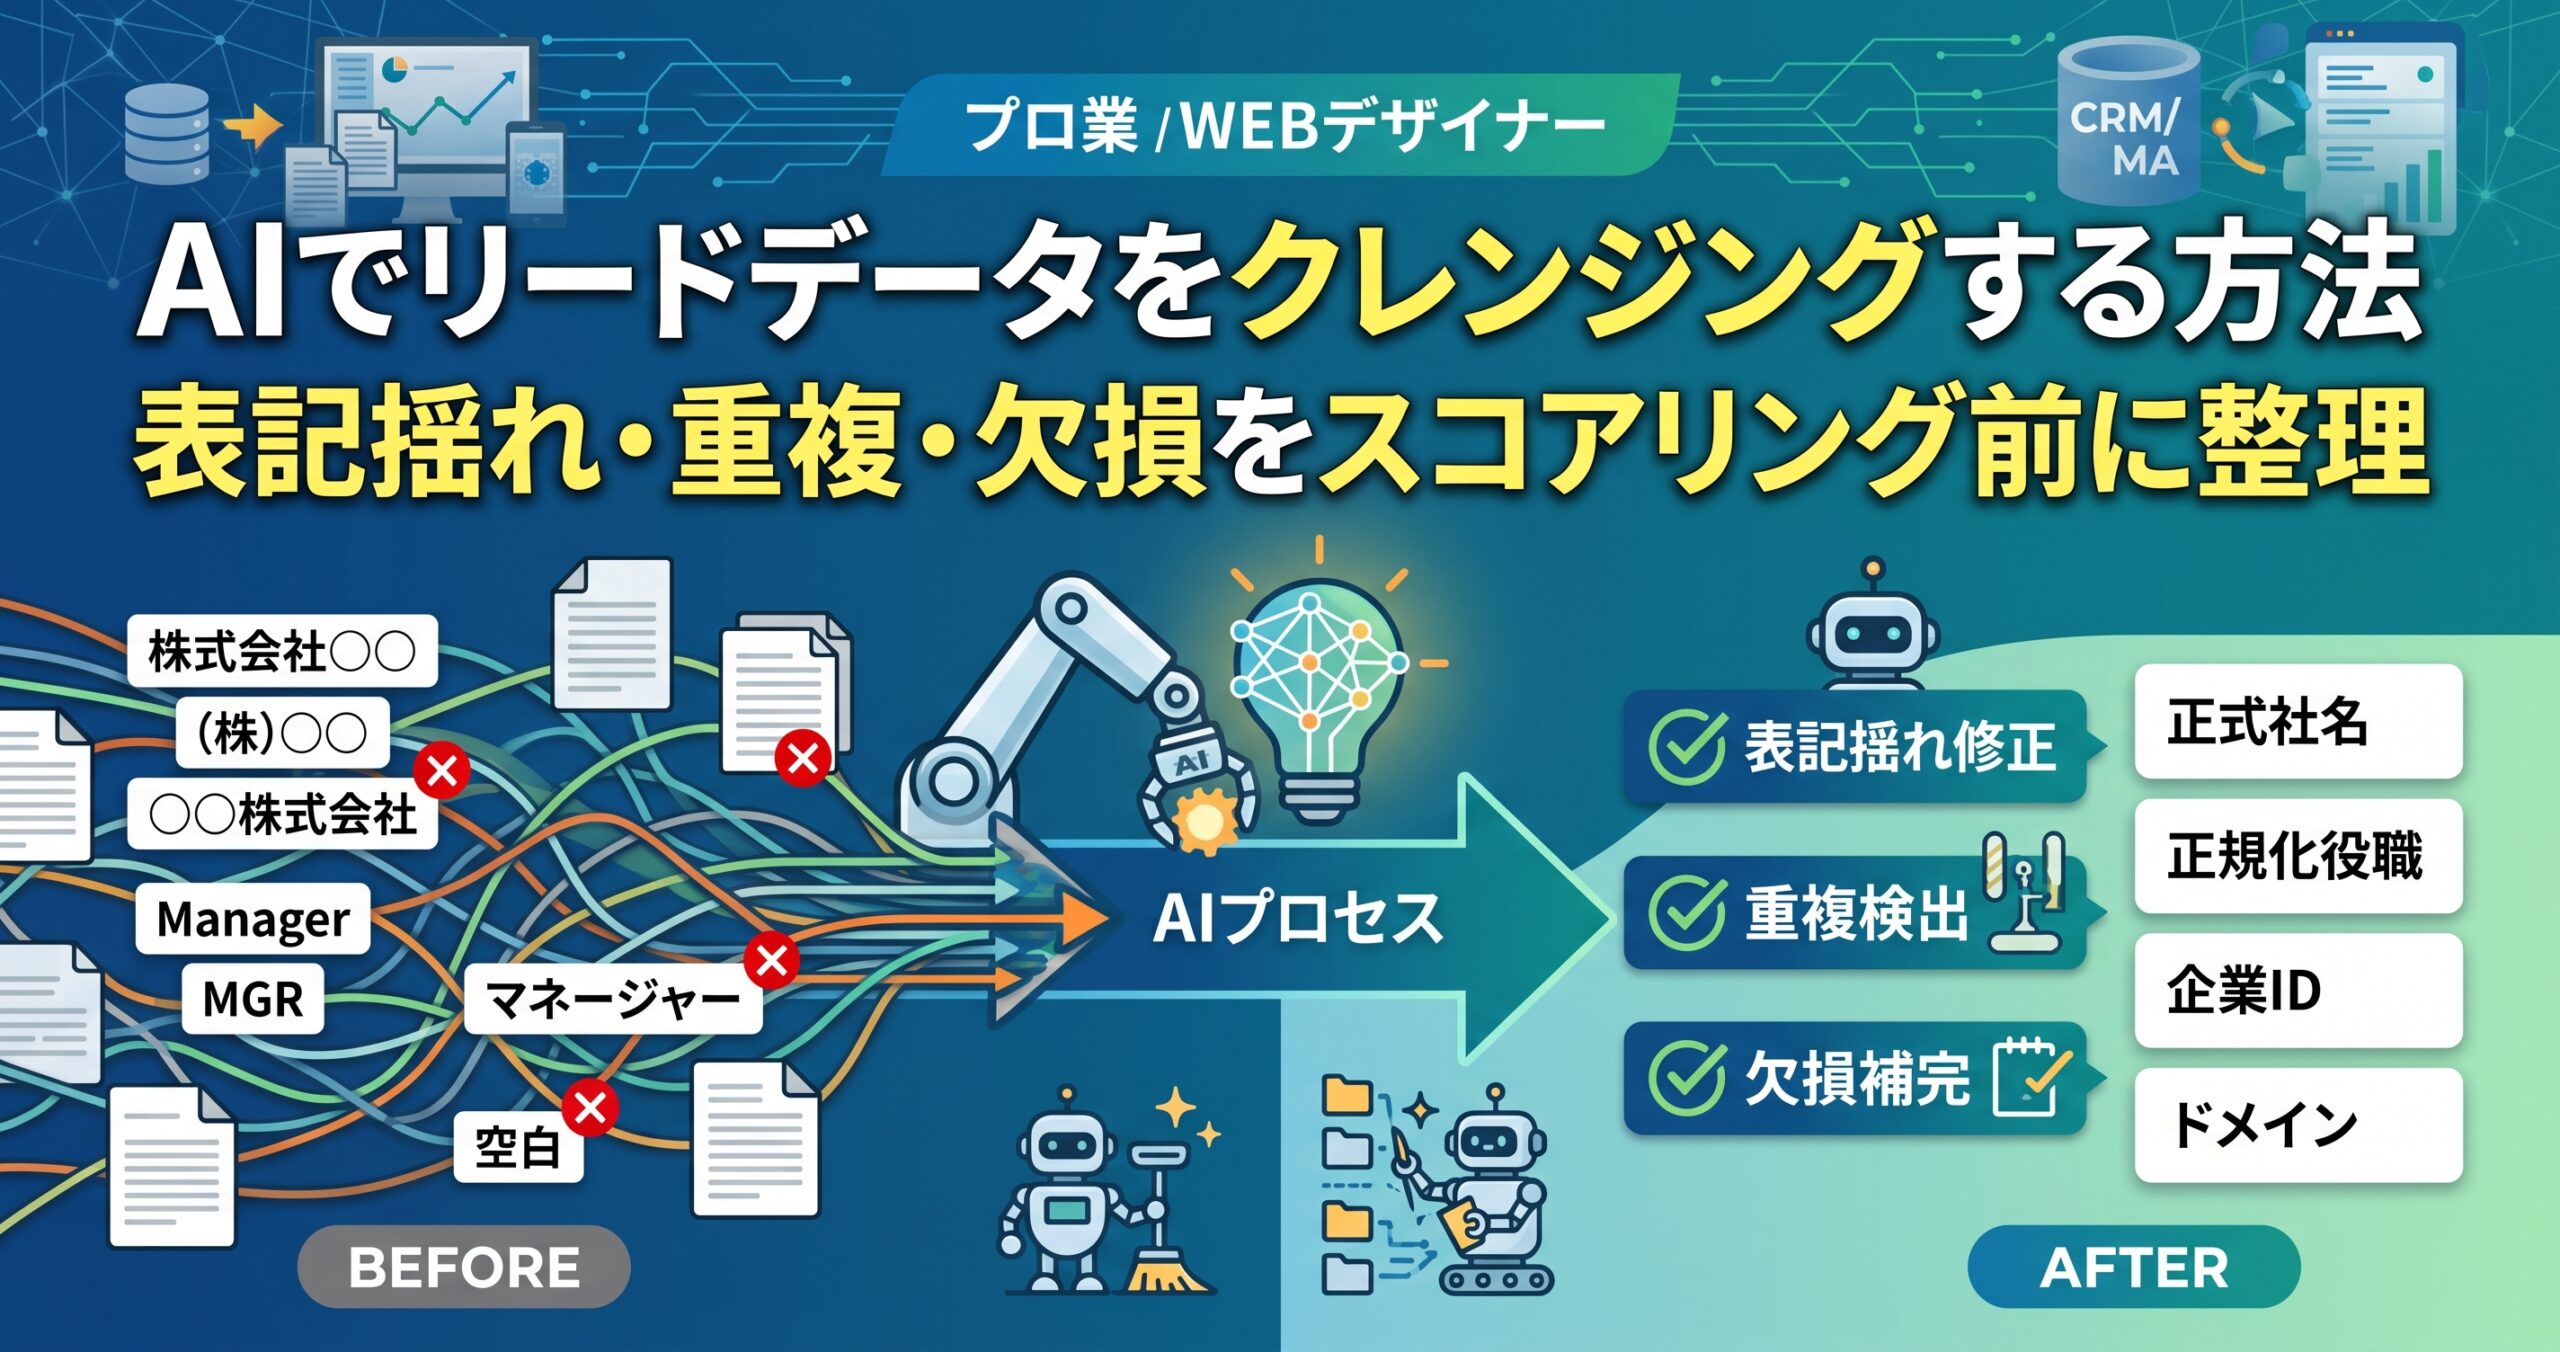
結論から言うと、AIでリードのQualificationやスコアリングを行う前に、会社名・部署名などの表記をそろえ、重複候補を検出し、企業・人物の単位を整理し、欠損や不明値を明確にする「データクレンジング」の工程を設けることが重要です。
AIは表記揺れの候補整理、重複候補の抽出、自由記述の分類、欠損項目の確認、企業情報の補完候補作成などを支援できます。
一方で、似ているレコードを自動的に同一人物と断定したり、不明な項目を推測で埋めたり、既存CRMの値をそのまま上書きしたりする運用は避ける必要があります。
本記事では、リードデータのクレンジングを、スコアリングやQualificationそのものではなく、その前工程として整理します。
この記事の要点
- リードデータのクレンジングは、Qualification・スコアリングより前に行うデータ整備工程です。
- 表記揺れの正規化、重複候補の検出、企業単位の名寄せ、欠損確認は別工程として考えます。
- 同じ会社の複数担当者を「重複」として消さないよう、企業・人物・案件の単位を分けます。
- AIは候補抽出や分類に活用し、確信できないマージや重要データの上書きは人へ戻します。
- CRMへ反映するときは、正本、更新ルール、変更履歴、データの出典まで決めます。
- リードデータのクレンジングとは?
- データクレンジング・名寄せ・マージ・エンリッチメントの違い
- なぜスコアリング・Qualificationの前にクレンジングするのか
- 会社名・部署名・役職名の表記揺れを正規化する
- 重複リードを検出する
- 「同じ会社」と「同じリード」を混同しない
- 欠損データはAIで勝手に埋めない
- AIで不足情報を補う場合は出典を残す
- 企業単位へ名寄せする
- AIとルールベースをどう使い分ける?
- AIでリードデータをクレンジングする実務フロー
- CRMへ反映するときのルールを決める
- クレンジング後にQualification・Scoringへ渡す
- データクレンジングは一度実施して終わりではない
- IMMNの一次情報から考えるリードデータ整備
- リードデータクレンジングの実務チェックリスト
- まとめ|AIで営業判断する前に「誰のデータか」を整える
- AIによるリードデータクレンジングに関するよくある質問
リードデータのクレンジングとは?
リードデータのクレンジングとは、CRM・MA・SFA等に蓄積した見込み顧客情報の表記揺れ、誤り、重複、欠損などを整理し、営業・マーケティングで同じ基準から利用できる状態へ整えることです。
例えば、同じ企業が次のように登録されている場合があります。
- 株式会社〇〇
- (株)〇〇
- 〇〇株式会社
- 〇〇 Inc.
人が見れば同じ企業だと気付けても、CRM上では別企業として集計される可能性があります。
さらに、展示会、資料請求、ウェビナー、問い合わせなど複数チャネルから同じ担当者が登録されれば、複数リードとして存在することもあります。
こうした状態のままAIへ渡すと、スコアリングやQualificationより前に、そもそも「誰・どの企業のデータなのか」がずれてしまいます。
データクレンジング・名寄せ・マージ・エンリッチメントの違い
データ整備では、すべてを「クレンジング」とまとめず、何をしている工程なのか分けて考えると運用しやすくなります。
| 工程 | 主な目的 | 例 |
|---|---|---|
| クレンジング | 値を利用可能な状態へ整える | 余分な空白、誤記、無効形式の確認 |
| 正規化 | 表現・形式をそろえる | 「MGR」「Manager」「マネージャー」を同一分類へ整理 |
| 重複検出 | 同一対象と思われる候補を探す | 同じメールアドレスのレコードを抽出 |
| 名寄せ | 複数レコードが同じ企業・人物か判断する | 社名+ドメイン+住所から同一法人候補を判定 |
| マージ | 重複レコードを一つへ統合する | 2件の担当者レコードを1件にまとめる |
| エンリッチメント | 不足情報を外部・内部情報から補う | 企業規模、法人情報、部署等の候補を追加 |
例えば、社名の表記をそろえただけでは「同じ会社か」は確定しません。
反対に、同じ会社だと分かっても、同じ会社に複数の担当者がいることは当然あります。
そのため、正規化と名寄せ、人物の重複統合は分けて処理します。
なぜスコアリング・Qualificationの前にクレンジングするのか
クレンジング前のデータでQualificationやスコアリングを行うと、元データの問題がそのまま営業判断へ引き継がれます。
| データ上の問題 | 下流で起こり得ること |
|---|---|
| 同じ企業が別名で登録 | 企業単位の接点・行動が分断される |
| 同じ人物が複数登録 | 行動や接触回数を重複して扱う |
| 別人物を同一人物として統合 | 異なる関心・商談履歴が混ざる |
| 部署名・役職名がばらばら | Fit判定やセグメントがずれる |
| 必須項目が欠損 | Qualificationが成立しない |
| 古い企業情報 | 現在の状況と異なる判定を行う |
| 不明値をAIが推測 | 未確認情報を事実として扱う |
そのため、実務工程は次のように分けます。
リード獲得 → クレンジング → 名寄せ・欠損確認 → Qualification → Scoring → Routing → Contact
Qualificationでは「このリードを営業へ進めるべきか」、Scoringでは「候補の中で誰を優先するか」を判断します。
その判断に入る前に、入力する企業・担当者データを整えるのが本記事の担当範囲です。
AIでリードクオリフィケーションを行う方法|営業へ渡す前に何を確認する?
会社名・部署名・役職名の表記揺れを正規化する
表記揺れは、AIにすべて自由解釈させるより、ルールで確定できるものと意味判断が必要なものを分けます。
会社名の表記揺れ
会社名では、法人格、スペース、全角・半角、英語表記などが混在します。
例えば、検索・照合用には正規化した社名を別項目に持ち、入力された原文も残しておく方法があります。
| 項目 | 値の例 |
|---|---|
| 入力原文 | 株式会社〇〇 |
| 正規化社名 | 〇〇 |
| 法人識別キー | 法人番号、企業ID等 |
| ドメイン | example.co.jp |
| 確認状態 | 確認済み/候補/要確認 |
会社名だけを消去・上書きするのではなく、検索用の正規化項目と表示用の正式名称を分けると、後から確認しやすくなります。
部署名・役職名の表記揺れ
部署名や役職名では、単純な文字置換より意味分類が必要になる場合があります。
例えば、
- マーケティング部
- デジタルマーケティング部
- マーケティング推進室
を「マーケティング系」と分類する、といった処理です。
役職でも、
- Manager
- MGR
- マネージャー
などを共通カテゴリへ整理できます。
AIは自由記述の意味分類に利用できますが、営業対象判定に使う場合は分類ルールを明文化します。
重複リードを検出する
重複検出では、「同じ値があるから自動統合」ではなく、確度の高い一致と曖昧な一致を分けます。
候補条件には、例えば次のようなものがあります。
| 一致情報 | 扱いの例 |
|---|---|
| 同一メールアドレス | 人物の重複候補として確認 |
| 同一法人番号・企業ID | 企業の同一候補として強い情報 |
| 同一ドメイン+類似社名 | 企業の重複候補 |
| 氏名+会社+部署 | 人物候補。ただし異動・同姓同名に注意 |
| 社名のみ類似 | 自動統合せず追加確認 |
AIは曖昧な表記の類似性を見つける候補生成には利用できます。
ただし、「株式会社〇〇東京」と「株式会社〇〇」のように、似ていても別法人・関連会社である場合があります。
曖昧なケースは、人のレビューへ戻します。
重複検出と統合は別工程にする
重複候補が見つかったからといって、その場で自動マージする必要はありません。
実務では、
- 重複候補を抽出する
- 一致根拠を表示する
- 統合してよいか確認する
- 残すレコードを決める
- 各項目で残す値を決める
- 関連する活動・商談の移行を確認する
- 統合履歴を残す
と分けます。
「同じ会社」と「同じリード」を混同しない
BtoBでは、企業単位の名寄せと人物単位の重複排除を分けることが特に重要です。
例えば一つの企業から、
- マーケティング担当者
- 営業企画担当者
- 情報システム担当者
- 決裁者
がそれぞれ資料をダウンロードしている場合、企業としては一社でも人物は別です。
これを一人のリードへ統合すると、誰がどのテーマへ関心を示したのか分からなくなります。
| 単位 | 主なキー | 残したい情報 |
|---|---|---|
| 企業 | 法人番号、企業ID、ドメイン等 | 企業属性、案件、企業全体の接点 |
| 人物 | メール、氏名、所属企業等 | 役割、本人の行動・接点 |
| 案件 | 案件ID等 | 検討テーマ、ステージ、金額、担当営業 |
| 行動 | イベント・日時等 | 閲覧、資料DL、ウェビナー等 |
「誰」「どの企業」「どの案件」のデータなのかを分けたうえで、必要な場面で関連付けます。
欠損データはAIで勝手に埋めない
欠損が見つかった場合、最初に「未入力」「不明」「対象外」「取得失敗」を区別します。
例えば従業員数が空欄の場合でも、
- フォームで質問していない
- 回答者が入力していない
- 公開情報から取得できなかった
- 取得処理がエラーになった
では意味が異なります。
AIに一律で値を補完させると、「推測」と「確認済みデータ」が混ざります。
欠損項目を4つに分類する
| 状態 | 意味 | 対応 |
|---|---|---|
| 未入力 | 入力されていない | 必要なら取得する |
| 不明 | 確認できない | 不明として保持 |
| 対象外 | そもそも該当しない | 対象外として保持 |
| 取得エラー | 処理に失敗した | 再処理・人へ確認 |
AIで不足情報を補う場合は出典を残す
AIを使ったデータエンリッチメントでは、補完した値だけではなく、どこから取得したかと確認状態を残します。
例えば企業情報を公開情報から補う場合は、
- 取得した値
- 情報源
- 取得日・更新日
- AIが抽出したのか、人が確認したのか
- 確信できない場合の候補
を区別します。
AIが検索して得た情報をそのままCRMの確定情報として保存するのではなく、候補データとして扱う工程を設けると安全です。
企業単位へ名寄せする
リードデータを営業判断へ使うには、個々のリードだけでなく「企業としてどのような接点があったか」を確認できる状態が重要です。
例えば同じ企業から、
- Aさんがウェビナー参加
- Bさんが資料ダウンロード
- Cさんが問い合わせ
している場合、それぞれの人物行動は分けて保持しながら、企業単位でも複数接点があることを確認できるようにします。
これにより、「一人の大量行動」と「企業内で複数人が動いている状態」を分けて考えられます。
企業名だけで名寄せせず、利用できる企業識別子、ドメイン、住所、公開情報など複数の根拠を使います。
AIとルールベースをどう使い分ける?
正解が明確な処理はルール、意味解釈や候補抽出はAI、誤統合の影響が大きい判断は人へ戻す設計が基本です。
| 処理 | ルール | AI | 人 |
|---|---|---|---|
| 全角・半角統一 | ◎ | △ | 不要な場合が多い |
| メール形式確認 | ◎ | △ | 例外確認 |
| 部署・役職分類 | ○ | ◎ | 重要ケース確認 |
| 曖昧な社名類似 | ○ | ◎ | 統合前確認 |
| 企業の同一判定 | ○ | ○ | 曖昧ケース確認 |
| 重複レコードのマージ | △ | 候補作成 | 重要データは確認 |
| 欠損情報の補完 | △ | 候補調査 | 確定・承認 |
特にCRMの既存顧客、商談中企業、重要顧客などは、誤った統合による影響が大きいため、人の確認条件を決めておきます。
AIでリードデータをクレンジングする実務フロー
一括でAIに「きれいにしてください」と依頼するのではなく、工程を分けて処理します。
- 利用目的とデータ単位を決める
- 元データを保持したまま現状を診断する
- 会社名・部署名・役職等を正規化する
- 確定ルールで重複候補を抽出する
- AIで曖昧な候補を整理する
- 企業・人物・案件の単位で名寄せする
- 欠損・古いデータを抽出する
- 必要な項目だけエンリッチメントする
- 曖昧・重要な変更を人が確認する
- CRMへ反映し、変更履歴を残す
- Qualification・Scoringへ渡す
- 営業結果からクレンジングルールを改善する
CRMへ反映するときのルールを決める
データクレンジングで最も重要なのは、「何を正しい値としてCRMへ残すのか」を事前に決めることです。
正本を決める
複数システムに同じ情報がある場合、項目ごとに優先する情報源を決めます。
| 項目 | 優先情報源例 | 注意点 |
|---|---|---|
| 正式企業名 | 確認済み企業情報 | 営業入力で安易に上書きしない |
| 担当者メール | 本人入力・確認済み情報 | 推測生成しない |
| 役職 | 最新確認情報 | 異動で変化する |
| 案件ステージ | 営業管理情報 | AI推測で変更しない |
| 関心テーマ | 行動・会話等 | 事実と推定を分ける |
元データを消さず変更履歴を残す
AIによる変換結果だけを残すと、誤変換が起きたときに確認できません。
少なくとも、
- 変更前
- 変更後
- 変更理由
- 適用したルール
- 処理日時
- AI処理か人の修正か
- 承認者
を必要に応じて追える状態にします。
クレンジング後にQualification・Scoringへ渡す
データを整えた後で初めて、「営業対象か」「誰から対応するか」という判断工程へ進めます。
| 工程 | 主な問い |
|---|---|
| クレンジング | データは同じ意味・形式になっているか |
| 名寄せ | これは同じ企業・人物か |
| Qualification | このリードは営業対象か |
| Scoring | 営業対象の中で誰から対応するか |
| Routing | 誰が担当するか |
| Contact | 何をどのチャネルで伝えるか |
この順番を分けることで、「重複しているからスコアが高かった」「部署名が違うだけでFit判定から外れた」といったデータ品質起因の問題を見つけやすくなります。
インテントスコアの精度を高める方法|データクレンジングとAI活用の実践ポイント
データクレンジングは一度実施して終わりではない
フォーム、展示会、ウェビナー、CSV取込、営業の手入力などから新しいデータが入り続ける限り、表記揺れ・重複・欠損は再発します。
そのため、
- 登録時の入力ルール
- 定期的な重複候補チェック
- 必須項目の欠損確認
- 古いデータの更新ルール
- AIの誤統合・誤分類レビュー
- 営業からの修正理由
を継続的に確認します。
データ品質の監視項目を決める
例えば社内管理では、
- 重複候補件数
- 名寄せ未確定件数
- 必須項目の欠損件数
- 人のレビュー対象件数
- AI候補の修正件数
- 統合後に戻した件数
などを追う方法があります。
一律の目標値を置くのではなく、自社データの通常状態を把握し、変化を見ます。
IMMNの一次情報から考えるリードデータ整備
AI活用では、AIモデルそのものより先に、入力するCRMデータが「誰の・どの企業の・どの状態の情報か」を整理することが重要です。
インティメート・マージャーが扱ってきたAI・データ活用の議論でも、CRMデータをAIで利用する前工程として、データの統合、重複コンタクトの名寄せ、役職等の表記揺れの正規化、不要データの分類、企業情報のエンリッチメントという流れが扱われています。
これは、AIに高度な営業判断を任せる前に、まず入力データの主語と意味をそろえる必要があることを示しています。
リード獲得業務へ置き換えると、
リードを集める → データを整える → 同じ企業・人物を特定する → 不足情報を確認する → Qualification → Scoring → 営業接触
という順番になります。
AIはこの中で、データ入力や候補分類といった反復処理を支援できます。一方で、営業対象の定義や、複数レコードを本当に統合してよいかという重要判断は、人と運用ルールを残します。
リードデータクレンジングの実務チェックリスト
| 確認項目 | なぜ重要か | 不足時の対応 |
|---|---|---|
| 企業・人物・案件を分けている | 異なる単位を誤統合しないため | データモデルを整理する |
| 入力原文を保持している | AI変換後を検証するため | 原文用項目を残す |
| 会社名・部署名の正規化ルールがある | 検索・分類条件をそろえるため | 正規形を定義する |
| 重複候補と確定重複を分けている | 誤マージを防ぐため | 確認ステータスを作る |
| 企業単位の識別キーがある | 社名だけに依存しないため | 企業ID・ドメイン等を整理する |
| 欠損と不明を区別している | AIの推測補完を防ぐため | 欠損状態を分類する |
| エンリッチ情報の出典を残している | 後から確認するため | 出典・取得日を保存する |
| 重要データの変更を人が確認する | 誤統合の影響を抑えるため | 承認条件を定義する |
| CRMの正本ルールがある | 連携先同士の上書きを防ぐため | 項目別の優先情報源を決める |
| Qualification前に品質確認する | 汚れたデータで営業判断しないため | 処理順を見直す |
まとめ|AIで営業判断する前に「誰のデータか」を整える
リードデータのクレンジングは、単なるCRMの整理作業ではありません。
Qualificationやスコアリングへ入る前に、
- 会社名・部署名・役職名の表記をそろえる
- 重複候補を抽出する
- 企業と人物を分けて名寄せする
- 欠損・不明・対象外を区別する
- 必要な企業情報だけ補完する
- AIの候補と確定事実を分ける
- 人が重要な統合を確認する
- CRMの正本と変更履歴を管理する
という工程が必要です。
AIを使えば、大量の表記揺れや重複候補を効率的に整理できます。
ただし、AIの目的は「自動的にCRMを書き換えること」ではありません。
QualificationやScoringの前に、営業・マーケティングが同じ企業・人物について同じデータを参照できる状態を作ることが重要です。
まず自社のCRMから100件程度をサンプルとして抽出し、「企業名の表記揺れ」「重複候補」「必須項目の欠損」「企業と人物の紐付け」の4点を確認すると、最初に整えるべき問題を把握しやすくなります。
整えたリードデータを、企業調査・優先順位付け・営業アプローチへつなげたい方へ
データクレンジングはAI営業のゴールではなく前工程です。その後には、企業情報の調査、Qualification、Scoring、営業への引き継ぎという判断工程が続きます。
アーカイブ配信「AIエージェントで実現する自動リサーチ・リード獲得の仕組み」では、データとAIを活用しながら企業リサーチからリード獲得・営業活用へ接続する考え方を紹介しています。
AIによるリードデータクレンジングに関するよくある質問
AIでリードデータを自動クレンジングできますか?
一部は自動化できます。表記の正規化、重複候補抽出、分類、欠損候補の整理などはAIやルールで支援できますが、曖昧な名寄せや重要レコードの統合は人の確認を残すことを推奨します。
データクレンジングと名寄せは同じですか?
同じではありません。クレンジングはデータを整える広い工程、名寄せは複数のレコードが同一企業・人物かを識別・関連付ける工程として分けると運用しやすくなります。
重複したリードはすべて削除すればよいですか?
削除する前に内容を確認します。異なるチャネルで取得した同一人物の履歴や、複数担当者の情報まで失わないよう、どのデータを残すかを決めます。
AIで欠損項目を自動入力してもよいですか?
推測による自動入力は避けるべきです。確認可能な情報源から取得した値か、AIによる候補か、不明なのかを区別して保存します。
リードデータのクレンジングはQualificationの前に行うべきですか?
基本的には前工程として整理する方が扱いやすいです。重複や表記揺れ、必須項目の欠損を整理してから、営業対象かどうかをQualificationで判断します。
会社名だけで企業の名寄せはできますか?
会社名だけでは誤判定する可能性があります。利用可能な範囲で法人識別情報、ドメイン、住所など複数の根拠を組み合わせます。
データクレンジングは一度実施すれば終わりですか?
継続運用が必要です。フォーム、展示会、ウェビナー、営業入力、CSV連携などから新しいデータが追加されるたびに、表記揺れ・欠損・重複が再発する可能性があるためです。

「IMデジタルマーケティングニュース」編集者として、最新のトレンドやテクニックを分かりやすく解説しています。業界の変化に対応し、読者の成功をサポートする記事をお届けしています。