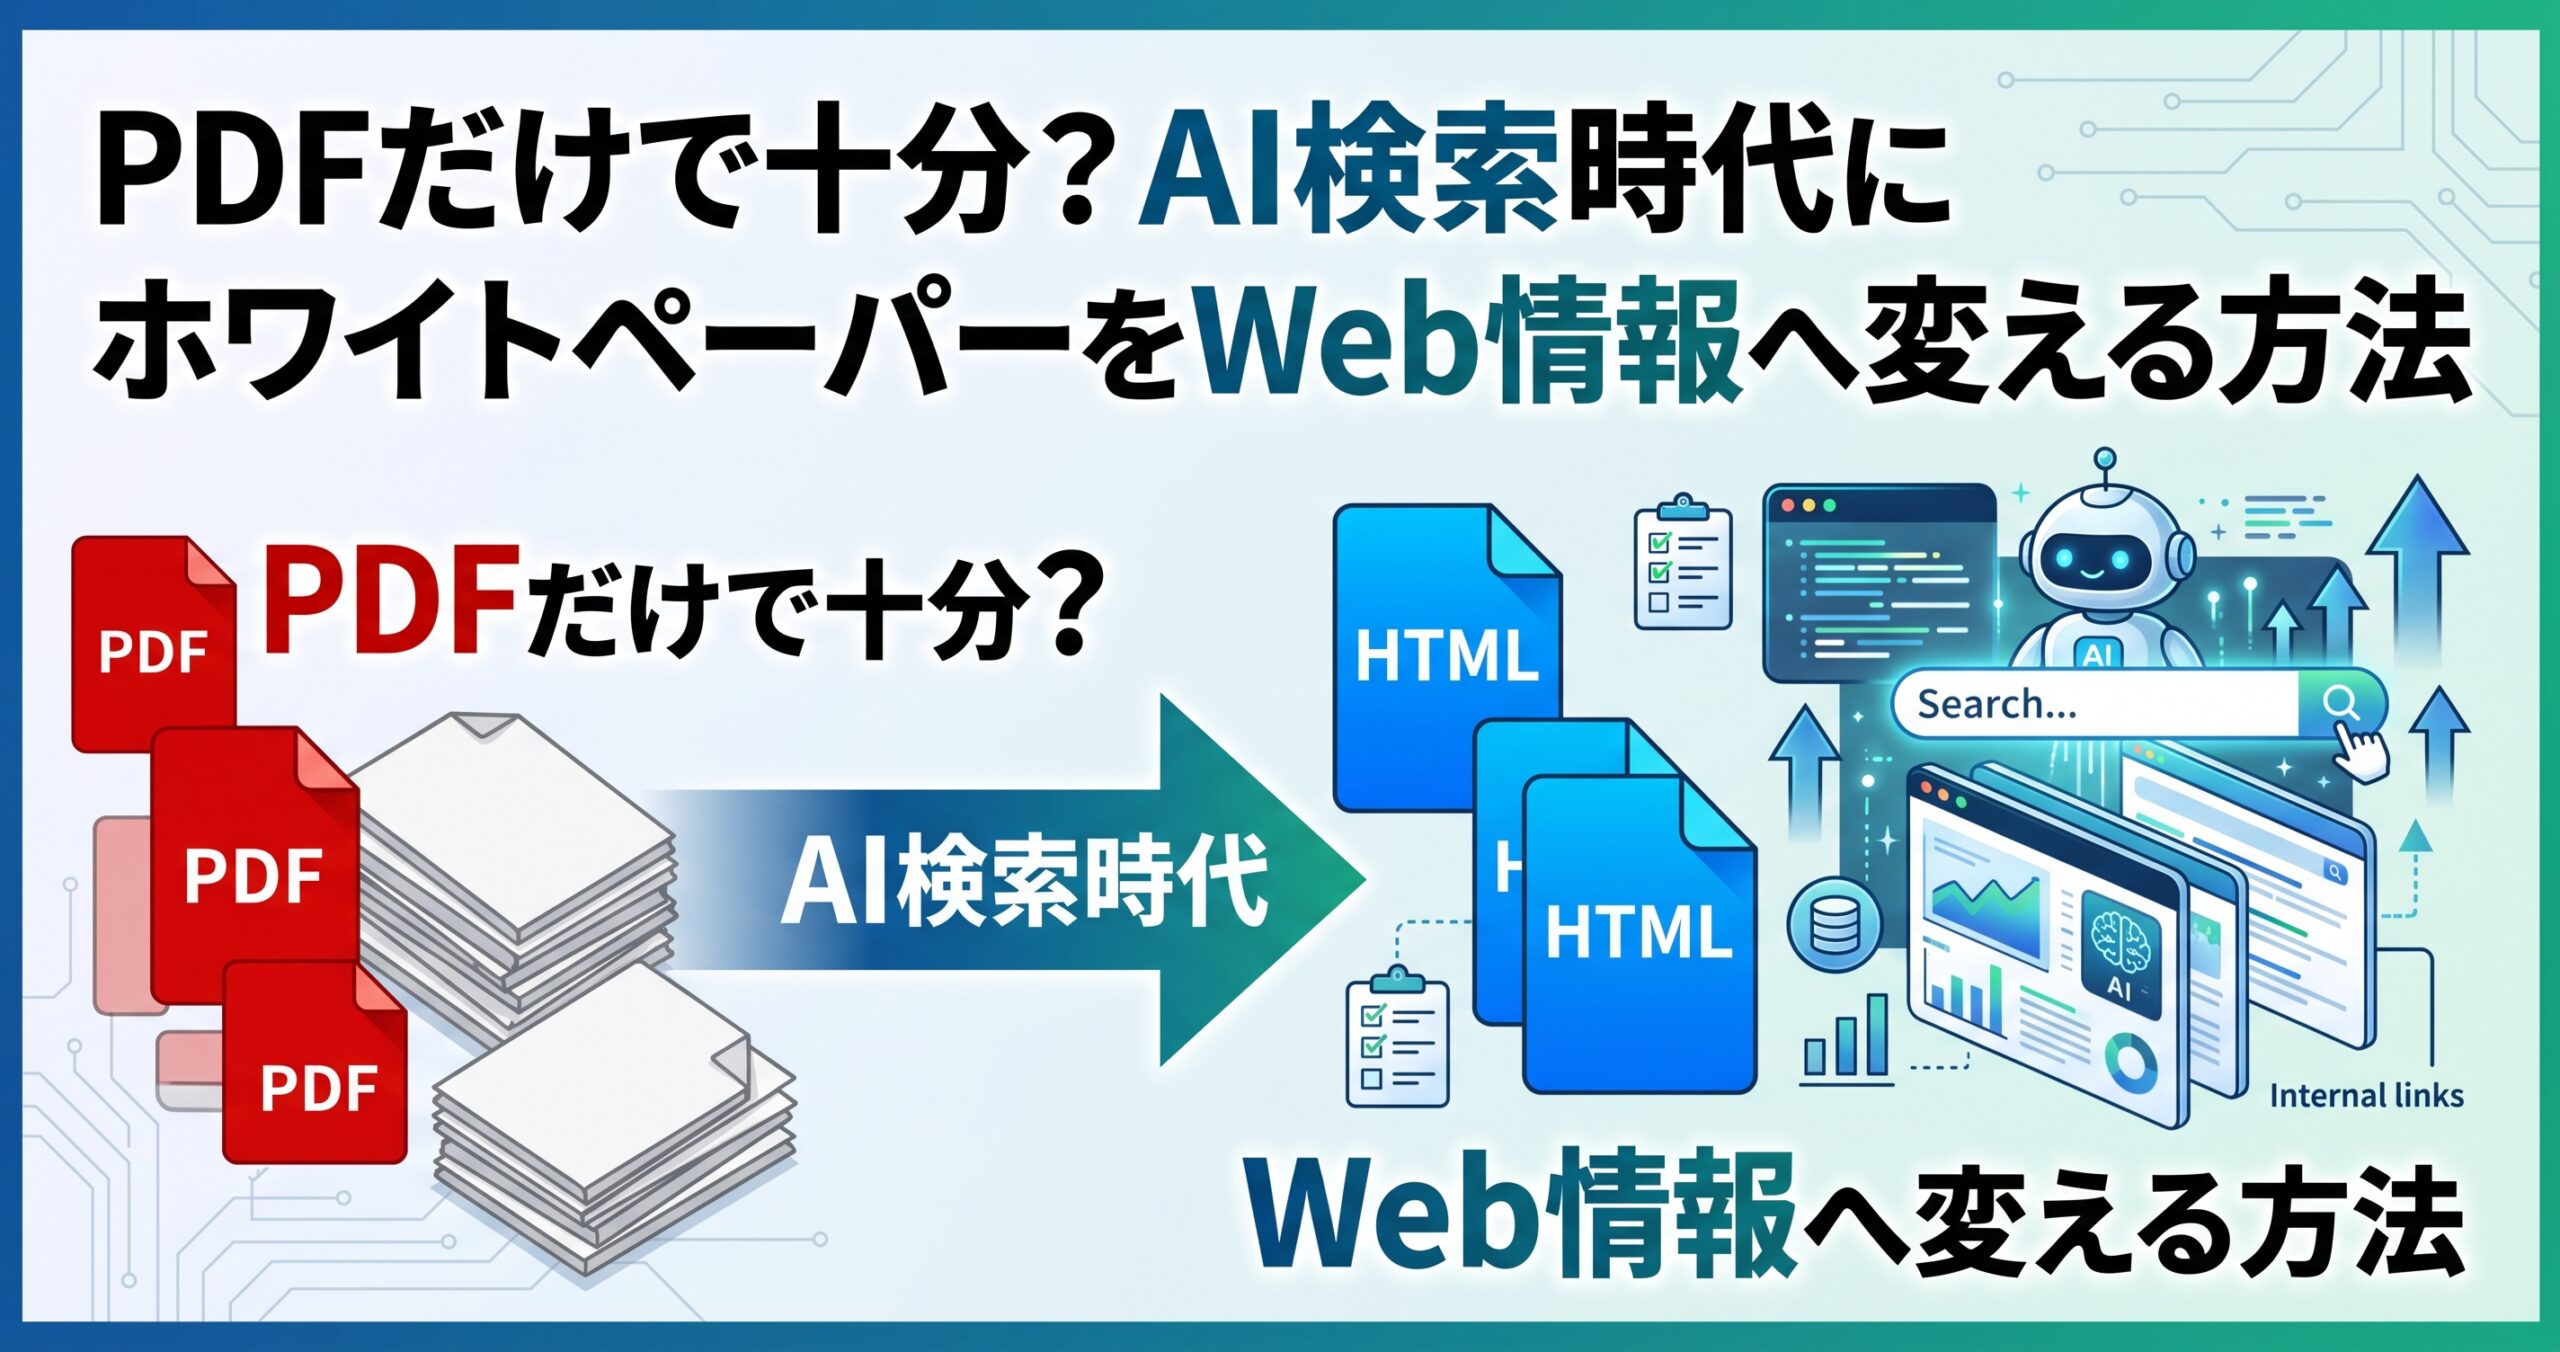
「調査レポートやホワイトペーパーは充実しているのに、検索流入につながっているのか分からない」「資料ダウンロードの中には詳しい情報があるが、Webページには概要しかない」「AI検索を考えると、PDFをすべて記事へ変えた方がよいのか」。BtoBのコンテンツ運用では、このような課題が起こります。
結論から言うと、PDFをすべてHTMLへ置き換える必要はありません。
PDFは保存・印刷・社内共有・詳細資料として残しながら、検索ユーザーの判断に必要な要点や一次情報をHTMLでも理解できる状態にすることが重要です。
Google検索ではPDF自体もインデックス対象になります。一方、HTMLページには、情報を見出し単位で整理し、関連記事へ内部リンクし、CTAやFAQを追加し、情報を部分的に更新しやすいという特徴があります。
そのため、AI検索時代のBtoBコンテンツでは「PDFかHTMLか」の二択ではなく、PDFとWebページの役割を分けることが実務的です。
本記事では、既存のホワイトペーパー・調査レポート・営業資料を、PDFの価値を残しながらWeb情報へ展開する方法を解説します。
この記事の要点
- PDFはGoogle検索のインデックス対象であり、「PDFだから検索されない」とは限りません。
- すべてをHTML化するのではなく、検索・比較判断に必要な要点をWebページでも説明します。
- HTML要約ページでは、結論・対象者・調査条件・主要データ・図表解説・FAQを優先します。
- PDFは詳細資料・保存・社内共有、HTMLは検索入口・回遊・更新・CTAという役割分担ができます。
- 同じ一次情報を記事、FAQ、比較表、セミナー、営業資料へ展開すると情報資産を再利用できます。
- PDFはAI検索やGoogle検索で読まれないのか?
- PDFとHTMLはどのように役割分担する?
- どのPDF情報をWebページ化するべき?
- HTML要約ページには何を書く?
- 図表は画像だけでなく「何が分かるか」をテキストで説明する
- ホワイトペーパーの一次情報を複数コンテンツへ再利用する
- フォームの先にあるPDFはどう考える?
- PDFとHTMLで同じ内容を公開してもよい?
- 内部リンクはどう設計する?
- CTAは「ダウンロードしてください」だけにしない
- PDFとHTMLの更新・差し替えをどう管理する?
- IMMNの一次情報から考えるPDF資産の再利用
- PDF・ホワイトペーパー活用の実務チェックリスト
- まとめ|PDFをなくすのではなく「検索入口」と「詳細資料」を分ける
- PDFとAI検索に関するよくある質問
PDFはAI検索やGoogle検索で読まれないのか?
PDFだから検索エンジンに読まれない、というわけではありません。GoogleはPDFをインデックス可能なファイル形式として扱っています。
そのため、AI検索対策を理由に、すでに公開しているPDFを機械的にすべてHTMLへ変換する必要はありません。
一方で、BtoBのPDFには別の課題があります。
- 重要な情報が長い資料の途中に埋もれている
- 図表だけを見ても意味や前提が分からない
- 関連する記事・事例へ移動しにくい
- 一部だけ更新したくてもPDF全体の差し替えが必要になる
- フォーム送信後にしか内容を確認できない
- 検索ユーザーが資料DL前に内容を判断しにくい
したがって課題は、「PDFという形式そのもの」ではありません。
検索・比較検討に必要な情報が、PDFの中にしか存在しない状態を見直すことが重要です。
PDFとHTMLはどのように役割分担する?
PDFは詳しく読む・保存する資料、HTMLは見つける・理解する・次へ進む情報として役割を分けると整理しやすくなります。
| 項目 | HTMLページ | |
|---|---|---|
| 主な役割 | 詳細資料・保存・共有 | 検索入口・要点理解・回遊 |
| 向いている情報 | 調査レポート、詳細資料、チェックリスト | 結論、定義、要点、比較、FAQ |
| 更新 | ファイル単位で差し替え | 必要箇所を更新しやすい |
| 内部リンク | 設計できるが運用に手間がかかりやすい | 関連記事を柔軟につなぎやすい |
| CTA | 資料内のCTA | 資料DL、記事、ウェビナー、問い合わせへ接続 |
| 情報探索 | 資料全体を読む | 見出し単位で必要情報を探しやすい |
例えば30ページの調査レポートを公開している場合、30ページすべてをWeb記事へコピーする必要はありません。
Web側では、
- 何を調査した資料なのか
- 誰に役立つのか
- 主要な結論は何か
- 特に重要なデータは何か
- そのデータから何が分かるのか
まで説明し、詳細データや全グラフはPDFで提供する方法があります。
どのPDF情報をWebページ化するべき?
Webページ化する優先度が高いのは、検索ユーザーの疑問や比較判断へ直接答える情報です。
PDF内の全情報を公開するのではなく、次の基準で選びます。
検索される疑問へ直接答えている情報
例えばホワイトペーパーの中に、
- ○○とは何か
- ○○と△△の違い
- 導入前に確認すべきこと
- よくある失敗
- 選定基準
が含まれているなら、独立したWebコンテンツへ展開できます。
自社にしかない一次情報
特にWeb化を検討したいのが、自社独自の情報です。
- 自社調査
- 顧客インタビュー
- 導入事例
- セミナーで得られた質問
- 実務上の失敗・改善例
- 独自データ
PDFの中だけに閉じている一次情報は、記事、FAQ、図表解説など別形式へ展開できないか確認します。
顧客が営業へ繰り返し質問している情報
営業やインサイドセールスが毎回説明している内容も、Web化候補です。
例えば、
- どの企業に向いているか
- 導入までに何が必要か
- 料金が決まる条件
- 他の方法との違い
- 成果を測る指標
などです。
HTML要約ページには何を書く?
HTML要約ページでは、PDFをダウンロードしなくても「自分に必要な資料か」を判断できる状態を作ります。
基本的には次の構成が使いやすいでしょう。
| 項目 | 記載する内容 |
|---|---|
| タイトル | 資料のテーマと得られる情報 |
| 対象者 | どのような課題を持つ人向けか |
| 結論 | 資料から分かる最重要ポイント |
| 調査・分析条件 | 対象、期間、方法、前提 |
| 主要データ | 特に重要な数値や結果 |
| 図表解説 | グラフが示す意味をテキストで説明 |
| 資料目次 | PDFで詳しく確認できる内容 |
| FAQ | DL前によく生じる疑問 |
| CTA | 資料ダウンロード、関連記事、セミナー等 |
「資料があります」だけではなく結論まで出す
よくあるのが、
「○○について詳しくまとめた資料です。ぜひダウンロードしてください」
だけのページです。
これでは検索ユーザーにとって、資料の中に欲しい答えがあるのか判断しにくくなります。
少なくとも重要な結論や対象者、主要な論点まではWeb上でも説明します。
図表は画像だけでなく「何が分かるか」をテキストで説明する
グラフや図解をWebへ掲載する場合は、画像を置くだけでなく、その図から何を読み取れるのかを周辺テキストで説明します。
例えば、調査グラフを掲載するなら、
- 何を比較しているグラフか
- 対象者は誰か
- 調査期間はいつか
- 最も大きな差は何か
- 実務でどう解釈するか
を本文でも説明します。
PDFではレイアウト上、グラフの近くに短いキャプションしか置けない場合がありますが、HTMLでは背景や注意点まで補足できます。
ホワイトペーパーの一次情報を複数コンテンツへ再利用する
PDFのWeb化は、1本のPDFを1本の記事へ変換する作業ではありません。資料内の論点を検索意図ごとに分解します。
例えば、「AI検索時代のBtoBマーケティング」というホワイトペーパーがある場合、次のように展開できます。
| PDF内の情報 | Webでの展開例 |
|---|---|
| 用語説明 | 用語解説記事 |
| 比較表 | 違い・使い分け記事 |
| 調査結果 | 独自調査記事 |
| チェック項目 | 実務チェックリスト記事 |
| 顧客事例 | 導入事例ページ |
| よくある質問 | FAQ記事 |
| 詳細版 | ホワイトペーパーPDF |
重要なのは、PDFをそのまま分割して大量の記事を作ることではありません。
検索意図が独立している論点だけを記事化し、同じ疑問へ答える情報は代表ページへまとめます。
フォームの先にあるPDFはどう考える?
リード獲得用のPDFをすべて公開する必要はありません。検索で見せる情報と、ダウンロード後に提供する情報を分けます。
例えば、
Webで公開する情報
- 課題の整理
- 主要な結論
- 代表的なデータ
- 調査条件
- 資料目次
PDFで提供する情報
- 全調査データ
- 詳細な分析
- 複数の図表
- 実務テンプレート
- チェックシート
- 詳細事例
という二層構造にできます。
これにより、検索ユーザーにはテーマへの回答を提供しつつ、さらに詳しく知りたい読者には資料DLという次の行動を提示できます。
PDFとHTMLで同じ内容を公開してもよい?
一部が重複すること自体を過度に恐れる必要はありませんが、同じ内容を二つのURLで全面的に競わせる必要もありません。
実務では、
- HTML=要点・判断材料・検索入口
- PDF=詳細版・保存版・配布資料
と役割を分ける方法が分かりやすいでしょう。
PDF全文とHTML全文がほぼ同一になる場合は、どちらを検索入口として扱うかをSEO・Web担当者と整理します。
本記事では技術設定そのものは扱わず、コンテンツの役割分担を優先します。
内部リンクはどう設計する?
HTML要約ページを作ったら、PDF単独では作りにくかった関連記事との接続を強化します。
例えば、
AI検索に関するホワイトペーパーであれば、
- AI検索とは
- LLMOとは
- AEOとは
- AI検索のKPI
- AI検索で引用されない原因
- 関連ウェビナー
などへつなげられます。
反対に、関連記事側からも、
「より詳しいチェックリスト・調査データは資料で確認できます」
とホワイトペーパーへ送客します。
つまり、
検索記事 → HTML要約 → PDF → Webinar・問い合わせ
だけでなく、
PDF要約ページ → 関連記事 → 比較検討 → Webinar
という回遊も作れます。
CTAは「ダウンロードしてください」だけにしない
CTAでは、資料を読むと何が判断できるのかを具体化します。
例えば、
- LLMOの実施状況をチェックする
- 自社に不足している情報を確認する
- 比較検討時のチェック項目を確認する
- 社内説明に使える一覧表を見る
などです。
資料名だけではなく、資料を読む目的をCTAへ入れると、Web本文からPDFへの流れを理解しやすくなります。
PDFとHTMLの更新・差し替えをどう管理する?
PDFをWeb展開するときに注意したいのが、同じ情報が複数箇所へ増えることです。
例えば調査数値を、
- 記事
- FAQ
- サービスページ
- 営業資料
へ掲載すると、更新時に数字が食い違う可能性があります。
そこで、一次情報の管理元を決めます。
| 管理項目 | 決めること |
|---|---|
| 元データ | どの資料・データを正とするか |
| 公開先 | どのURL・PDFに使用しているか |
| 確認日 | 最後に内容を確認した日 |
| 担当者 | 更新責任者 |
| 更新トリガー | 統計更新、仕様変更、サービス変更等 |
| 版管理 | PDFの更新日・版番号 |
PDFを差し替えたのにHTMLには古い数字が残っている、という状態を避けます。
IMMNの一次情報から考えるPDF資産の再利用
BtoB企業では、価値のある情報が記事になる前に、セミナー、営業資料、ホワイトペーパー、調査資料として蓄積されていることがあります。
インティメート・マージャーでも、AI検索・LLMOの記事制作では、過去のセミナーや長尺資料をそのまま要約するのではなく、検索ユーザーが知りたい論点へ分解し、記事・FAQ・比較表・チェックリストなどへ再構成する考え方を採用しています。
この考え方をPDFへ当てはめると、重要なのは「PDFをHTML化すること」そのものではありません。
PDFに含まれている一次情報の中から、検索ユーザーの判断に必要な情報を見つけ、適切なWebページへ配置し直すことです。
ホワイトペーパーを制作するときから、
- この章はSEO記事にできるか
- この表は比較記事に再利用できるか
- この質問はFAQにできるか
- この調査結果は一次情報記事にできるか
まで考えておくと、一つの調査・資料を複数チャネルで利用できます。
PDF・ホワイトペーパー活用の実務チェックリスト
| 確認項目 | なぜ重要か | 不足している場合 |
|---|---|---|
| PDFが一般公開されているか把握している | 検索対象になり得る範囲を把握するため | 公開・非公開条件を整理 |
| 検索ユーザー向けのHTML入口がある | 資料内容をDL前に判断できるため | 要約ページを作成 |
| 主要な結論がWebでも分かる | 「資料があります」だけにしないため | 結論・要点を追加 |
| 図表をテキストでも説明している | 前提・意味を理解しやすくするため | キャプション・解説を追加 |
| 独自データを再利用している | 一次情報を眠らせないため | 調査記事・FAQ等へ展開 |
| PDFとHTMLの役割が異なる | 同一内容の重複ページを増やさないため | 要約版と詳細版へ整理 |
| 関連記事へ内部リンクしている | 資料DLだけで回遊を止めないため | 基礎・実践・事例記事を接続 |
| CTAの価値が明確 | DLする理由を伝えるため | 資料で分かることをCTAへ追加 |
| 更新元と担当者が決まっている | WebとPDFの情報差異を防ぐため | 管理表と更新ルールを作成 |
まとめ|PDFをなくすのではなく「検索入口」と「詳細資料」を分ける
AI検索時代だからといって、BtoB企業がPDFやホワイトペーパーをやめる必要はありません。
PDFには、
- 保存しやすい
- 社内共有しやすい
- レイアウトを保てる
- 詳細情報をまとめやすい
という役割があります。
一方で、検索・AI検索を含むWeb上の情報探索を考えると、重要な情報をPDFだけに閉じるのではなく、HTMLでも要点を理解できるようにする方法があります。
考え方は、
PDFかHTMLか
ではなく、
HTMLで何を見つけてもらい、PDFで何を深く理解してもらうか
です。
まずは既存のホワイトペーパーを棚卸しし、独自データ、FAQ、比較表、チェックリスト、導入事例など、検索ユーザーにも役立つ一次情報がPDFの中だけに眠っていないか確認してみてください。
PDF・記事・FAQを含め、AI検索時代の情報資産をまとめて見直したい方へ
PDFのWeb化はLLMO・AEO対策の一部分です。実務では、サイト内の記事、FAQ、企業情報、比較情報、一次情報、内部リンクまで含めて確認する必要があります。
アーカイブ配信「生成AI時代に選ばれる企業とは? LLMO・AEO実践チェックリスト2026」では、自社サイトやコンテンツを見直すための確認ポイントを実務向けに整理しています。
PDFとAI検索に関するよくある質問
PDFはGoogle検索にインデックスされますか?
はい。GoogleはPDFをインデックス可能なファイル形式として扱っています。ただし、公開されているPDFが必ずクロール・インデックス・表示されることを保証するものではありません。
AI検索対策ではPDFをすべてHTMLに変えるべきですか?
いいえ。PDFは詳細資料として残し、検索ユーザーの判断に必要な要点だけHTMLで提供する方法があります。
ホワイトペーパーをフォームの後ろに置いてもよいですか?
はい。リード獲得を目的とする場合は詳細版をフォーム後に提供し、検索入口となるWebページでは結論・主要データ・目次などを公開する方法があります。
PDFとHTMLで内容が重複しても問題ありませんか?
一部の重複を過度に恐れる必要はありませんが、同じ全文を別URLで競わせるより、HTMLを要約・検索入口、PDFを詳細版として役割分担すると管理しやすくなります。
PDFの図表はそのまま画像でWebへ掲載すればよいですか?
画像だけでなく、その図が何を示しているのか、対象・期間・主要な結果などをテキストでも説明することをおすすめします。
PDFをHTML化するとAI検索に引用されやすくなりますか?
HTML化だけでAI検索への引用を保証することはできません。重要情報を検索・読者が理解しやすい形にし、内部リンクや更新管理を行いやすくする施策として考えます。
どのPDFからWeb化を始めるべきですか?
独自調査、顧客事例、比較表、FAQなど、一次情報が多く、検索ユーザーの疑問へ直接答えられるPDFから優先すると整理しやすいでしょう。

「IMデジタルマーケティングニュース」編集者として、最新のトレンドやテクニックを分かりやすく解説しています。業界の変化に対応し、読者の成功をサポートする記事をお届けしています。